
O web scraping com JavaScript muitas vezes falha não porque o código está errado, mas porque a rota de acesso escolhida foi a errada. Se os dados já estão no HTML inicial, o fetch do Node.js mais um parser de HTML bastam. O navegador só se torna necessário quando a página precisa executar JavaScript, paginar, clicar ou interagir de alguma forma antes que os dados apareçam, e é essa a linha que separa HTML estático de páginas renderizadas.
O Playwright é uma ótima escolha para fluxos conhecidos de antemão e repetidos com frequência: abrir a página, esperar por um elemento, clicar em um controle, extrair os campos e percorrer o mesmo caminho outra vez. O problema começa quando a estrutura da página, a paginação ou o fluxo de interação muda e uma sequência fixa de seletores e ações começa a quebrar.
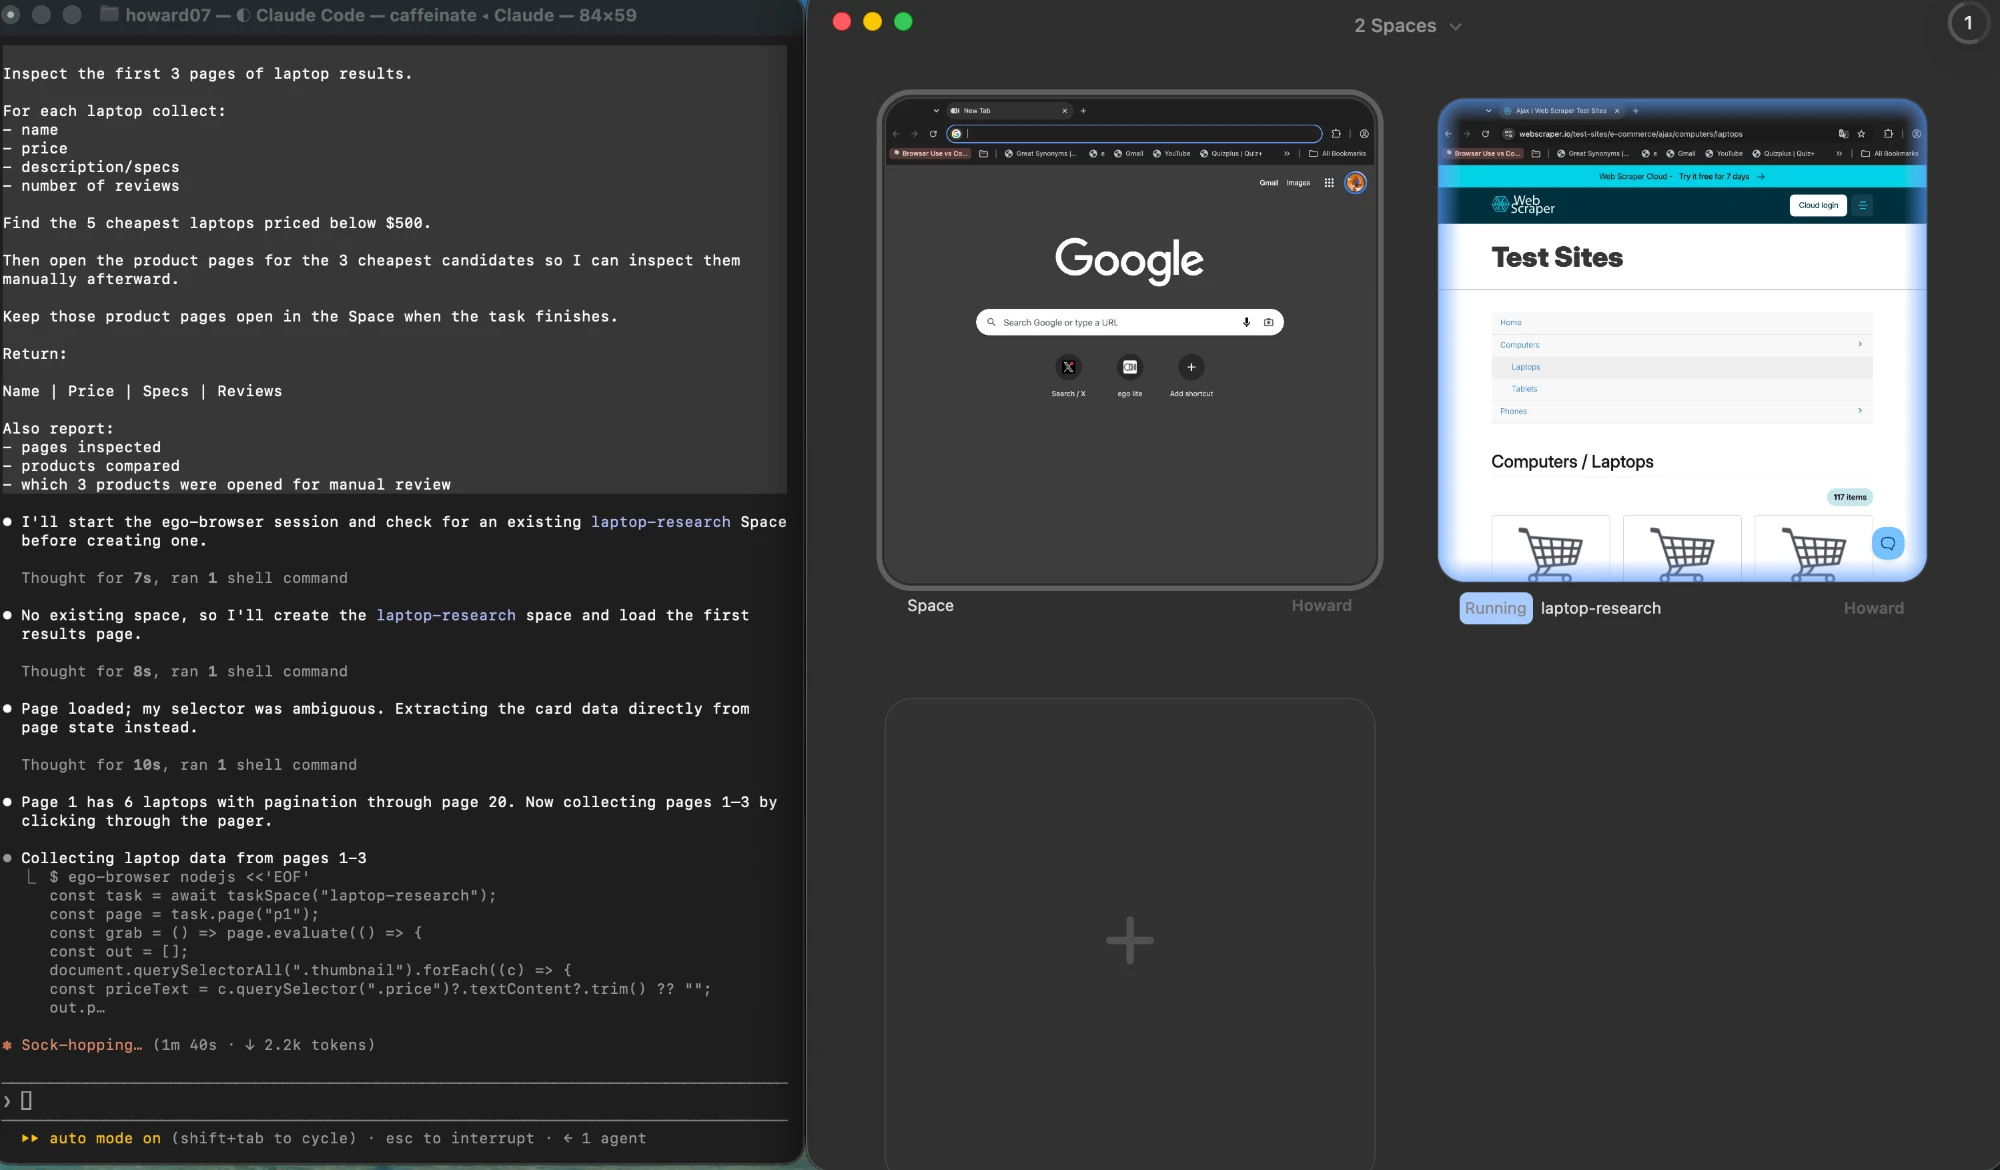
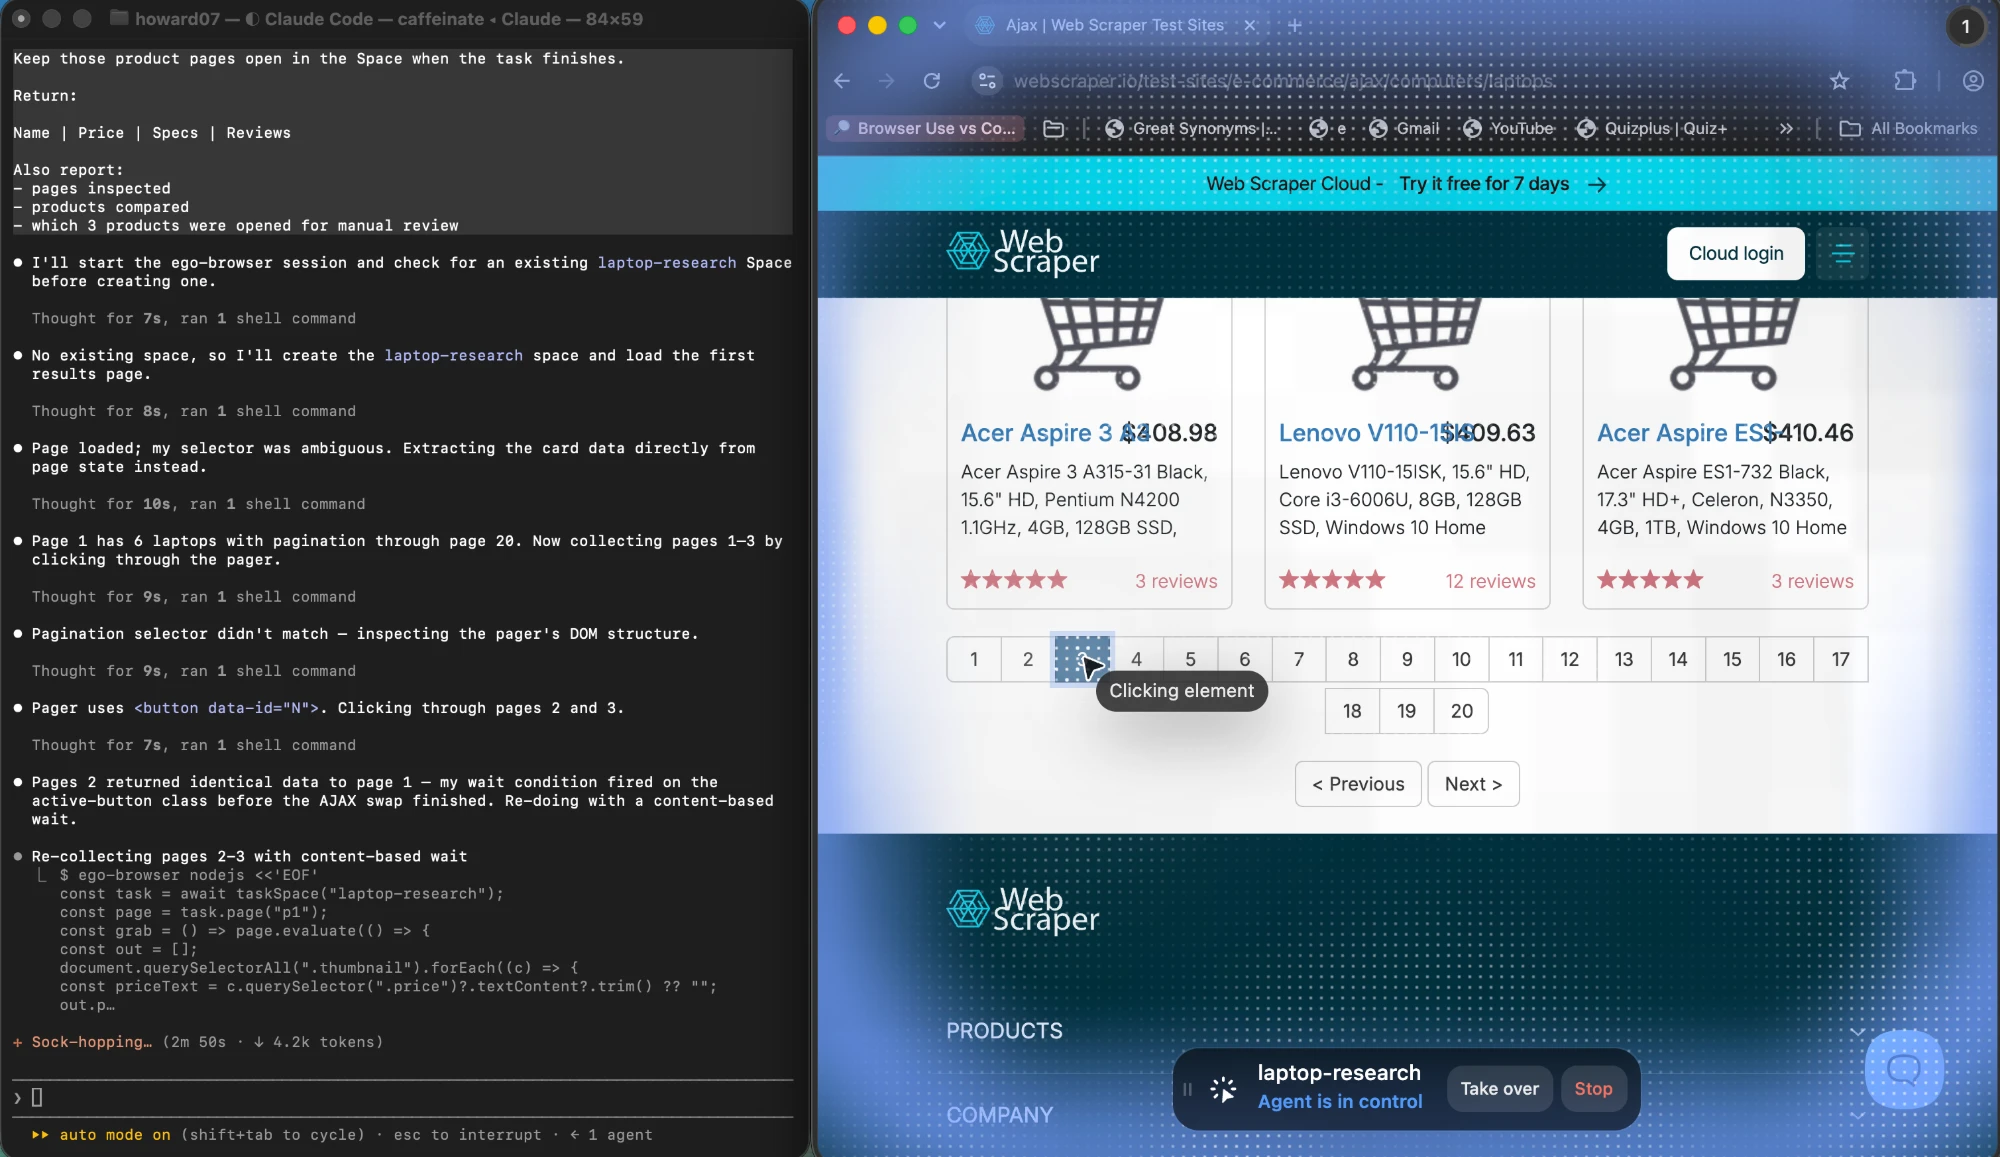
É aí que um navegador orientado por agente, como o ego (lite), se encaixa melhor. Em vez de presumir que o caminho original ainda existe, o agente pode inspecionar a página renderizada no momento, decidir o próximo passo e continuar executando de forma confiável depois de uma navegação ou de mudanças dinâmicas.
O que realmente decide se um scraper JavaScript funciona?
A rota de acesso decide o resultado. O mesmo site alvo pode ser trivialmente raspável por HTTP e completamente opaco a HTTP, dependendo de os dados chegarem na resposta HTML inicial ou serem buscados e renderizados depois por JavaScript em execução no navegador.
Então a primeira tarefa não é escrever um scraper. É abrir a página alvo, ver o código-fonte em vez do DOM renderizado e descobrir onde os valores que você quer realmente ficam. Todo o resto deste guia decorre dessa resposta.
Qual das três rotas de acesso o seu alvo precisa?
Três rotas cobrem quase todo trabalho de scraping, e elas estão ordenadas por custo. HTML estático é a mais barata e rápida. Um endpoint JSON que a página já chama costuma ser o dado mais limpo que você vai obter. Um navegador real é o mais capaz e o mais caro em CPU, memória e fragilidade.
| Rota | O que consegue fazer | O que não consegue fazer |
|---|---|---|
| Requisição HTTP + parser de HTML | Buscar qualquer URL diretamente, ler o corpo da resposta e consultar a marcação retornada. Processa milhares de páginas por minuto por processo e não precisa de binário de navegador. | Executar scripts da página, clicar, rolar ou preencher formulários. Em uma página renderizada no cliente, retorna a casca vazia, porque os dados nunca estiveram na resposta. |
| Endpoint JSON direto | Retornar dados estruturados sem analisar marcação, então os nomes dos campos sobrevivem a reformulações do layout da página. Menor payload, análise mais rápida. | Manter-se estável entre atualizações do site. Esses endpoints são internos, não documentados e podem mudar ou passar a rejeitar requisições sem aviso. |
| Automação de navegador real | Executar o JavaScript da página, esperar o conteúdo aparecer e interagir com o resultado renderizado exatamente como uma pessoa faria. | Escalar com baixo custo. Cada contexto de navegador consome memória de verdade, e uma frota deles exige mais infraestrutura do que um loop HTTP. |
Como buscar e analisar HTML estático no Node.js?
Comece pela plataforma. O Node.js expõe a Fetch API como global, então uma requisição não precisa de nenhuma dependência. O padrão abaixo é a primeira rota inteira: requisitar, verificar o status, ler o texto e entregar a marcação a um parser.
A própria requisição não precisa de nada além da plataforma, porque a Fetch API vem como global do Node.js, então um GET simples não tem nenhuma biblioteca HTTP para instalar.
A verificação de status é a parte que as pessoas removem primeiro e mais sentem falta. Um 404 ou uma página de bloqueio de bot ainda retorna um corpo, e esse corpo é analisado alegremente como zero elementos correspondentes, o que parece exatamente um bug de seletor.
const res = await fetch(url, {
  headers: { "user-agent": "my-scraper/1.0 (+contact@example.com)" },
});

if (!res.ok) {
  throw new Error(`${res.status} ${res.statusText} for ${url}`);
}

const html = await res.text();
A limitação de taxa pertence ao mesmo loop, e não a um remendo posterior. Um atraso aguardado entre requisições mantém um trabalho pequeno educado e mantém seu endereço fora de uma lista de bloqueio:
const sleep = (ms) => new Promise((r) => setTimeout(r, ms));

for (const url of urls) {
  const html = await getHtml(url);
  await parse(html);
  await sleep(1000);
}
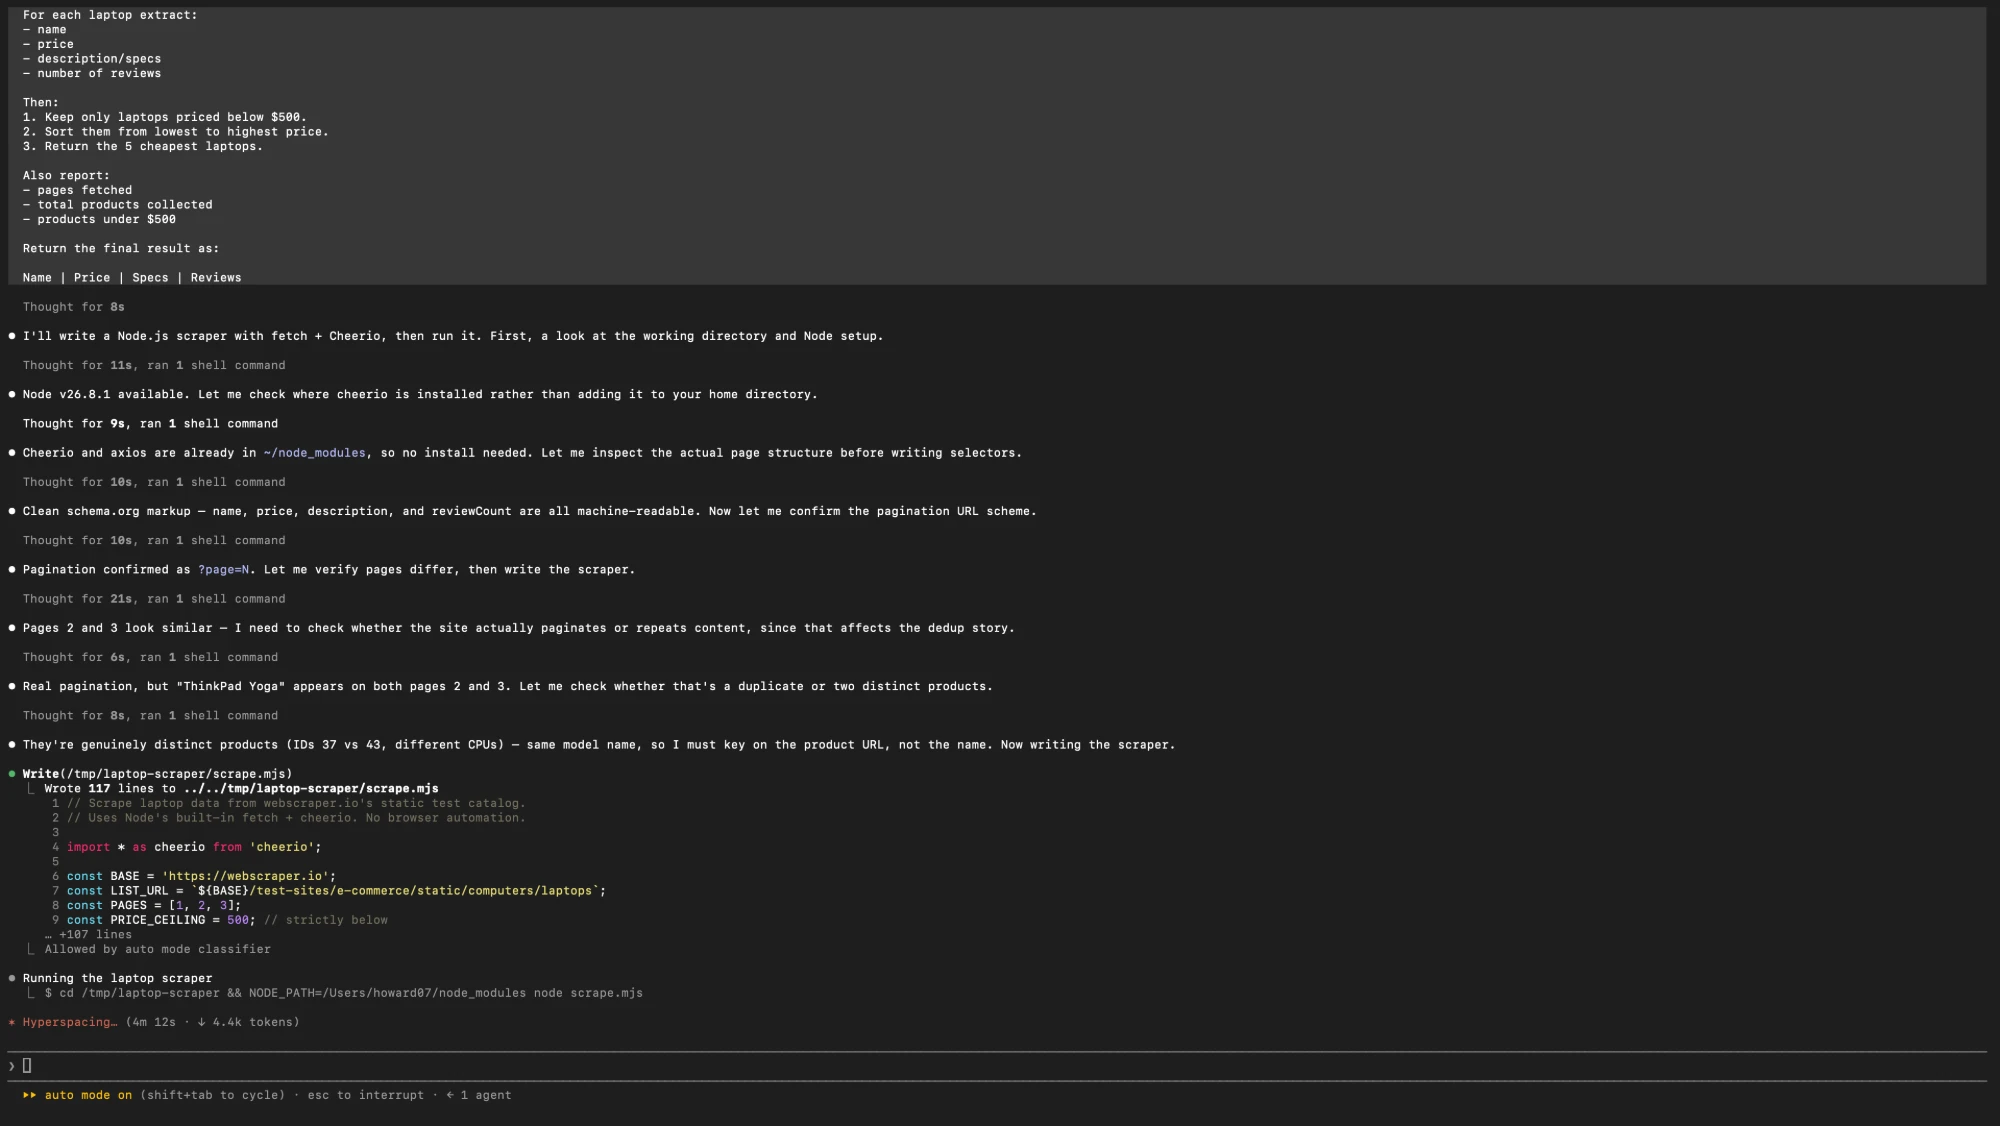
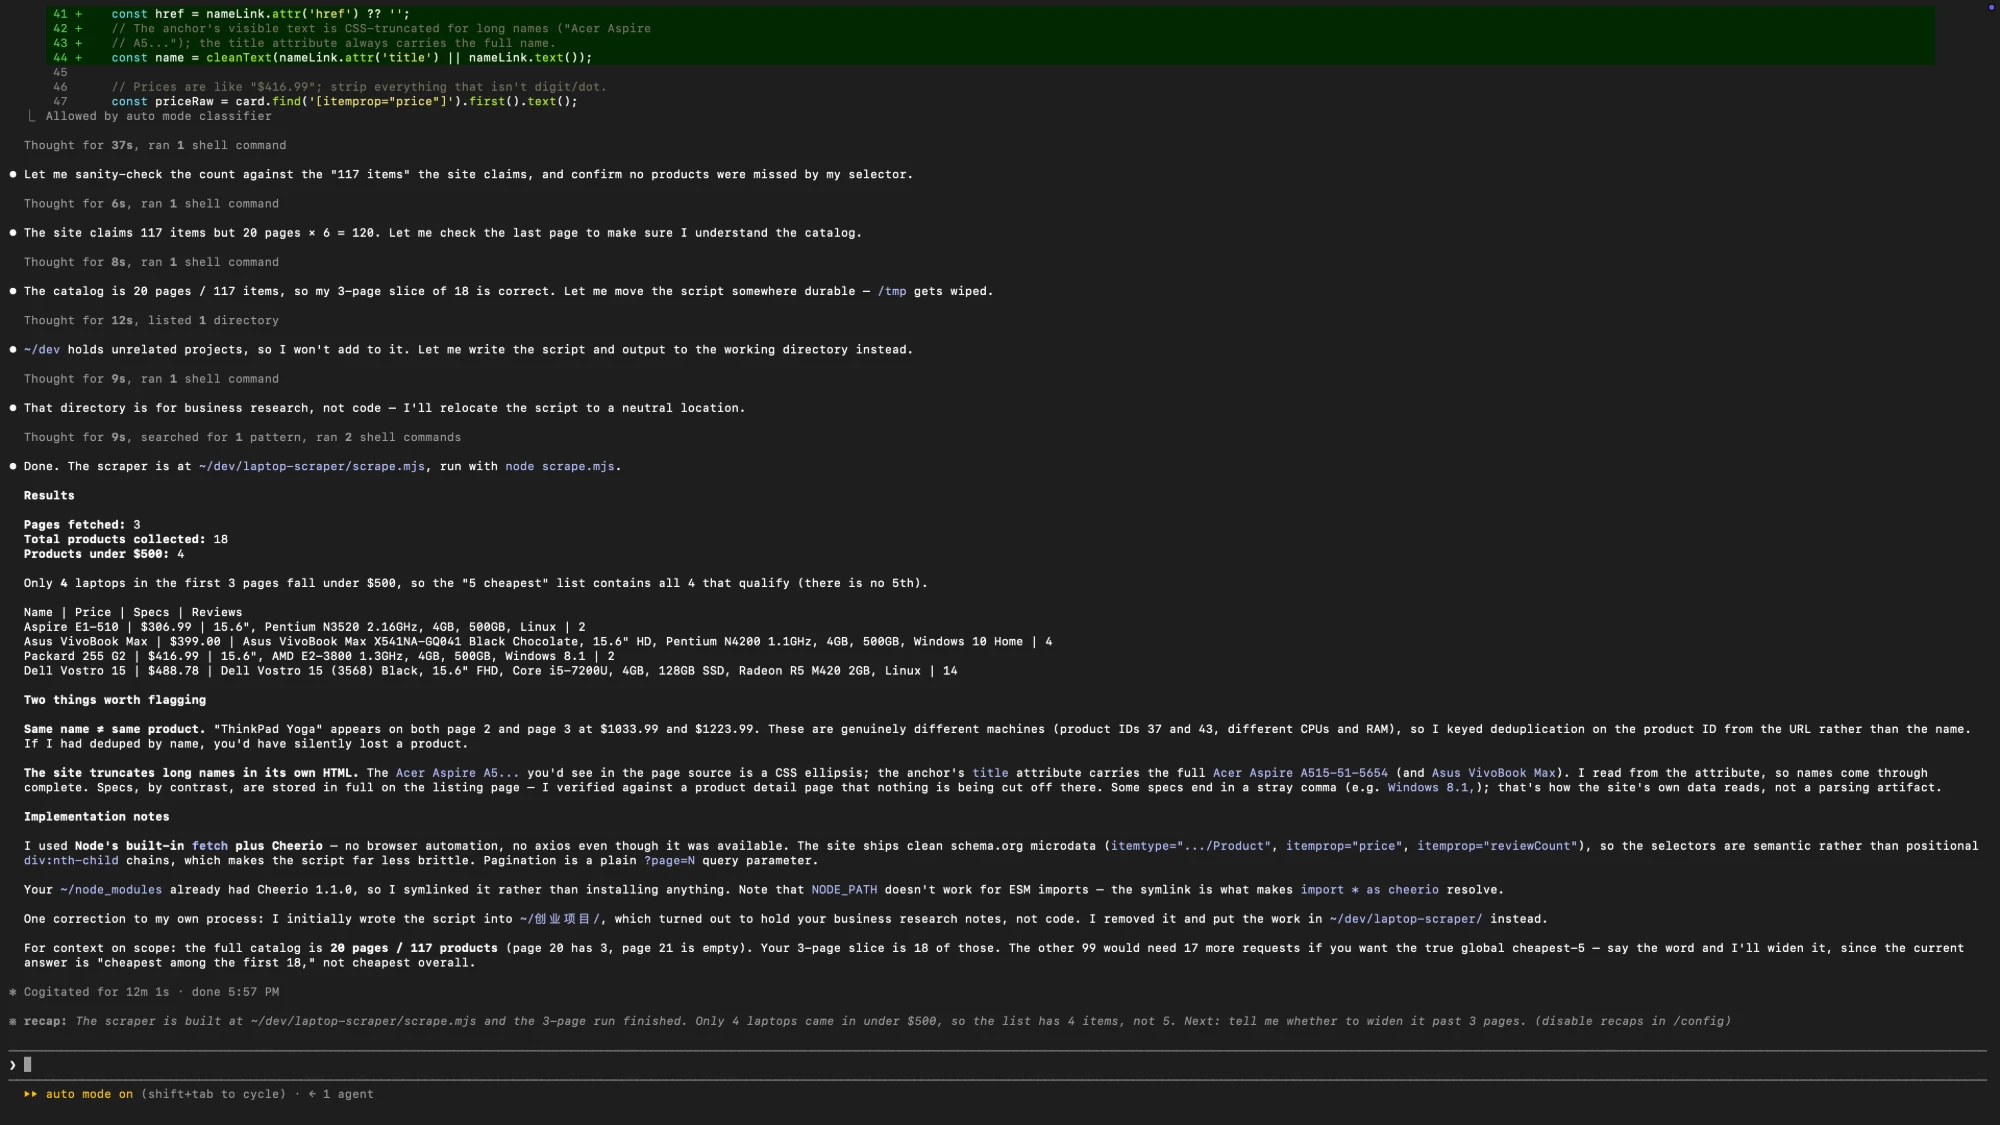
Veja o que essa primeira rota realmente retorna. A tabela abaixo é saída real de uma requisição HTTP simples mais uma biblioteca de seletores sobre um catálogo público de notebooks para teste: sem navegador, sem etapa de renderização, três páginas buscadas como três respostas estáticas.
| ID | Nome | Preço | Especificações | Avaliações |
|---|---|---|---|---|
| 32 | Aspire E1-510 | $306.99 | 15.6", Pentium N3520 2.16GHz, 4GB, 500GB, Linux | 2 |
| 45 | Asus VivoBook Max | $399 | 15.6" HD, Pentium N4200 1.1GHz, 4GB, 500GB, Windows 10 Home | 4 |
| 31 | Packard 255 G2 | $416.99 | 15.6", AMD E2-3800 1.3GHz, 4GB, 500GB, Windows 8.1 | 2 |
| 46 | Dell Vostro 15 | $488.78 | 15.6" FHD, Core i5-7200U, 4GB, 128GB SSD, Radeon R5 M420 2GB, Linux | 14 |
Quatro produtos entre os dezoito custam menos de $500. Esse é todo o resultado da rota um neste catálogo: três requisições, nenhuma renderização, nenhum processo de navegador. E é aí também que começa a parte honesta, porque falta nesta tabela algo que um leitor esperaria ver.
Cheerio, DOMParser ou jsdom: qual parser usar?
Esses três são comparados como se fossem bibliotecas intercambiáveis. Não são, porque fazem promessas diferentes: dois deles analisam marcação para consulta, e um deles implementa um DOM com execução de scripts.
O parser em que este guia se apoia está documentado em cheerio.js.org, que deixa explícito que o Cheerio analisa e consulta a marcação em vez de executar os scripts da página.
| Opção | O que consegue fazer | O que não consegue fazer |
|---|---|---|
| Cheerio | Analisar uma string de HTML rapidamente e consultá-la com seletores no estilo jQuery. Dependência pequena, sem navegador, ideal para algumas centenas de campos de um corpo de resposta. | Executar scripts da página, renderizar componentes ou resolver layout. Ele analisa marcação; não se comporta como um navegador. |
| jsdom | Fornecer uma implementação de DOM no Node.js com document, window e execução de scripts, para que código escrito contra APIs de navegador rode sem alterações. | Igualar um navegador real em renderização ou fidelidade, e é muito mais pesado por página. É um substituto de DOM, não o Chrome. |
| DOMParser | Transformar uma string em um documento consultável usando uma API de navegador embutida, sem adicionar nenhuma dependência ao projeto. | Ser aguardado: ele é síncrono e bloqueante, e no Node.js só se tornou global em versões recentes. |
A leitura no Cheerio usa a API de seletores familiar. Observe que o texto extraído passa por trim na fronteira, porque a marcação raspada carrega indentação e quebras de linha que, de outro modo, apareceriam no seu conjunto de dados:
import * as cheerio from "cheerio";

const $ = cheerio.load(html);
const items = $(".product-card").map((i, el) => ({
  name: $(el).find(".name").text().trim(),
  price: $(el).find(".price").text().trim(),
})).get();
A mesma extração com DOMParser fica assim, e só funciona onde esse global existe:
const doc = new DOMParser().parseFromString(html, "text/html");
const rows = [...doc.querySelectorAll("table tbody tr")].map((tr) => ({
  cells: [...tr.querySelectorAll("td")].map((td) => td.textContent.trim()),
}));
Como encontrar o endpoint JSON que a página já usa?
Antes de escrever um único seletor, abra o painel de rede do navegador, filtre por fetch e XHR, recarregue a página e veja o que voltou. Muitos sites orientados a dados montam a página visível a partir de um pequeno número de respostas JSON, muito mais fáceis de consumir do que a marcação.
Quando encontrar uma, a requisição normalmente precisa dos mesmos cabeçalhos que a página enviou e, às vezes, de um cookie de sessão. Reproduza-a com a saída copy-as-fetch do painel de rede, em vez de remontá-la à mão.
const res = await fetch("https://example.com/api/listings?page=1", {
  headers: { accept: "application/json" },
});

if (!res.ok) throw new Error(`${res.status} for listings page 1`);

const { items } = await res.json();Por que uma página renderizada no cliente retorna uma casca vazia?
Uma página renderizada no cliente envia uma marcação que quase não contém conteúdo. A resposta inicial traz um elemento raiz, um pacote de scripts e, talvez, um estado de carregamento. O texto que uma pessoa vê na tela é criado pelo JavaScript depois que a resposta chega, então uma requisição HTTP que apenas lê a resposta não tem nada para ler.
Isso é diagnosticável, não misterioso. Duas verificações capturam a maioria dos casos: o texto visível na resposta é uma fração pequena do que o navegador mostra, e a marcação é dominada por tags script:
const text = html.replace(/<script[\s\S]*?<\/script>/g, "").replace(/<[^>]+>/g, " ").replace(/\s+/g, " ").trim();

console.log({
  textLength: text.length,
  scriptCount: (html.match(/<script\b/g) ?? []).length,
  hasRoot: /id="(root|app|__next)"/.test(html),
});
Texto curto, muitos scripts e uma div raiz vazia juntos significam que a terceira rota é a resposta honesta. Algumas dezenas de caracteres de texto sem nenhuma tag script geralmente significam algo mais simples: a requisição foi bloqueada, ou você pediu a URL errada.
Como a diferença aparece na prática:
| Sinal na resposta HTTP | O que costuma significar | Próximo passo |
|---|---|---|
| Conteúdo completo, marcação real | O servidor renderizou a página. Nada mais é necessário. | Analise com uma biblioteca de seletores. |
| Div raiz e muitos scripts | Renderização no lado do cliente. O conteúdo chega depois da resposta. | Procure o endpoint JSON ou renderize a página. |
| Texto muito curto, sem scripts | Bloqueado, redirecionado ou a URL totalmente errada. | Registre status, URL final e cabeçalhos antes de analisar. |
Como o Playwright faz scraping de uma página em navegador real?
O Playwright controla um navegador real, então a página executa exatamente como faria para um visitante. O formato do scraping é menor do que a maioria espera: abrir um contexto, ir até a URL, esperar pela coisa específica de que você precisa e então lê-la.
A superfície de API usada aqui está documentada em playwright.dev, a referência canônica para iniciar navegadores, contextos e locators.
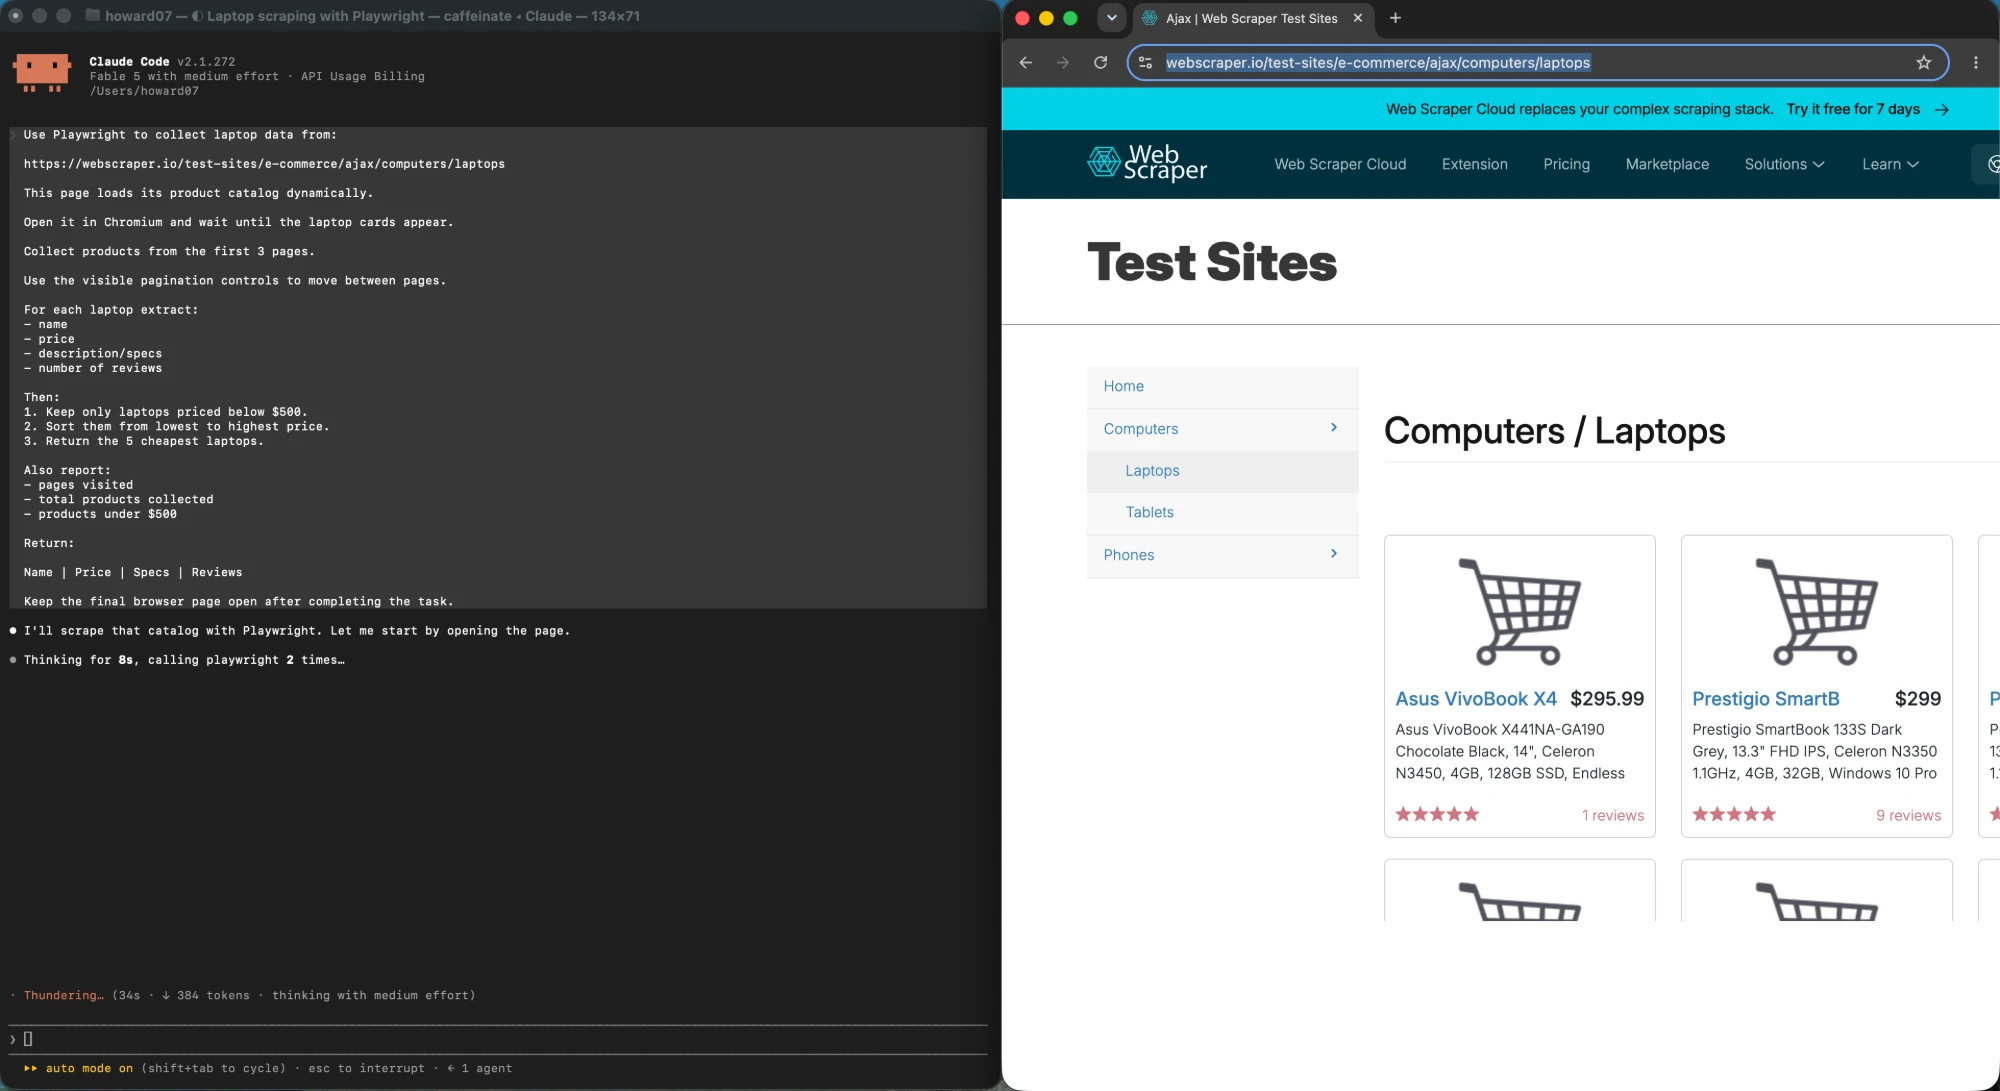
O padrão de recuperação abaixo espera por um seletor e então extrai via page.evaluate, que executa sua função dentro da página e retorna um resultado serializável:
import { chromium } from "playwright";

const browser = await chromium.launch();
const context = await browser.newContext();

try {
  const page = await context.newPage();
  await page.goto(url, { waitUntil: "domcontentloaded" });
  await page.waitForSelector(".product-card");

  const rows = await page.evaluate(() =>
    [...document.querySelectorAll(".product-card")].map((el) => ({
      name: el.querySelector(".name")?.textContent?.trim() ?? null,
      price: el.querySelector(".price")?.textContent?.trim() ?? null,
    })),
  );

  console.log(rows);
} finally {
  // contexts hold the memory; close it even when the scrape throws
  await context.close();
  await browser.close();
}
Dois detalhes de ciclo de vida importam mais do que os seletores. Um contexto é a unidade descartável barata, então um navegador pode atender várias execuções isoladas, e cada uma termina com um close. O segundo é que a extração de texto na página retorna nós de texto, não valores renderizados: conteúdo oculto por CSS continua no DOM e ainda vai aparecer na sua saída.
Quando o alvo é um elemento específico e não a lista inteira, os locators são o caminho de recuperação mais limpo. A própria documentação de locators do Playwright observa que esperar por um clique não é necessário para botões, links e campos de entrada, o que vale lembrar antes de envolver cada interação em uma espera explícita:
const title = await page.getByRole("heading", { level: 1 }).innerText();
const price = await page.locator("[data-testid=price]").innerText();
Como sessões, risco de bloqueio e CAPTCHA mudam o plano?
No momento em que um alvo exige login, o scraper deixa de ser um exercício de dados e passa a ser um problema de gerenciamento de sessão. O Playwright dá suporte direto a isso: autentique uma vez, salve o estado de armazenamento do navegador em um arquivo e reutilize-o em execuções posteriores, em vez de programar o preenchimento de credenciais a cada vez.
// once, interactively
await context.storageState({ path: "auth.json" });

// later runs
const context = await browser.newContext({ storageState: "auth.json" });
Duas verdades operacionais decorrem disso. O estado de sessão salvo é uma credencial, então pertence a um cofre de segredos, não ao repositório. E uma sessão salva expira, então uma execução que de repente começa a retornar páginas de login é um problema de sessão, não de seletor.
Manter esse estado vivo entre inicializações é um tópico à parte: sessões de navegador persistentes entre execuções de agente percorrem isso em detalhe.
Para tráfego automatizado em geral, três restrições decidem se você tem um trabalho de scraping ou uma luta perdida: o que as diretivas robots e os termos do site permitem, qual taxa o site publica ou tolera e se a resposta que você recebe é o conteúdo ou uma página de desafio. São questões de política para resolver antes de escrever código, e elas são tratadas com mais profundidade no nosso guia sobre scraping atrás de barreiras de login.
O que quebra um scraper JavaScript em produção?
Scrapers raramente falham porque um seletor estava errado. Eles falham na segunda execução, contra a centésima URL, quando uma página está mais lenta, uma resposta é um redirecionamento ou o site começa a limitar a taxa. As correções não têm glamour e são específicas.
async function getWithRetry(url, attempt = 0) {
  const res = await fetch(url);
  if (res.status === 429 || res.status >= 500) {
    if (attempt >= 3) throw new Error(`giving up on ${url}`);
    const retryAfter = Number(res.headers.get("retry-after"));
    const waitMs = Number.isFinite(retryAfter)
      ? retryAfter * 1000
      : 2 ** attempt * 1000;
    await new Promise((r) => setTimeout(r, waitMs));
    return getWithRetry(url, attempt + 1);
  }
  if (!res.ok) throw new Error(`${res.status} for ${url}`);
  return res.text();
}
A concorrência é a segunda armadilha. Dez contextos de navegador em paralelo na mesma máquina vão basicamente disputar a mesma CPU, então o ganho de throughput é menor do que o custo de memória, e o site vê um pico em vez de um fluxo constante. Comece sequencial, meça e só então aumente o número se o alvo tolerar.
A terceira é que qualquer scraper que lê um endpoint sem promessa precisa de um fallback. Mantenha no código a análise por seletores da página visível e deixe uma chamada JSON malsucedida cair nela, para que uma mudança silenciosa no upstream degrade a execução em vez de esvaziá-la.
Quando um navegador real é realmente necessário?
Um navegador real é a resposta certa quando a tarefa precisa de algo que só um navegador oferece: uma sessão autenticada que já existe na sua máquina, conteúdo que só aparece após interação, um fluxo em que uma pessoa precisa entrar no meio do caminho ou um resultado que deve ser acompanhado enquanto acontece, e não buscado. Fora desses casos, HTTP com um parser é mais rápido, mais barato e mais fácil de manter rodando.
O trade-off entre um navegador headless e um navegador real é tratado em navegador headless vs navegador real para agentes de IA.
É nessa situação que um agente de navegador orientado por tarefa passa a valer a pena. ego (lite) é um navegador feito para trabalho orientado por agente: você descreve o objetivo, e ele opera em um navegador real, incluindo as sessões já conectadas que você mantém abertas, com uma interface visível que você pode assumir quando um passo exige julgamento humano. Para tarefas de scraping que precisam de um estado de login real, de uma página dinâmica, de execução visível ou de uma passagem para um humano, isso elimina o trabalho de ligar sessões descrito acima. Não é um substituto do Playwright, e não promete nada em relação a todo site: páginas que respondem com um desafio, ou que proíbem acesso automatizado, estão fora dos limites para ele do mesmo modo que estão para qualquer outra rota. Onde uma requisição HTTP simples ou uma API oficial já retorna o que você precisa, adicionar um agente de navegador só tornaria o trabalho mais lento.
Para uma comparação mais profunda das ferramentas de navegador quando o navegador é de fato a resposta, nosso comparativo de scraping Playwright vs Puppeteer cobre a escolha da biblioteca em si, e fluxos de trabalho de scraper com IA cobre onde os agentes se encaixam em um pipeline de scraping.
Quais são os principais desafios e limitações?
Toda rota neste framework tem um modo de falha que você não consegue eliminar com engenharia, e conhecê-los de antemão é o que separa um scraper que roda por um ano de um que roda por uma semana.
A análise estática quebra quando o site reformula sua marcação. Ela não tem como perceber, então um campo que vira null silenciosamente é mais comum do que uma falha completa. Valide uma amostra a cada execução em vez de confiar no pipeline.
Endpoints JSON internos quebram sem aviso nenhum, e são a parte menos contratual de qualquer site. Uma execução bem-sucedida hoje não é evidência sobre o mês que vem.
A automação de navegador é a mais realista e a mais frágil em escala. A memória cresce com a concorrência, as sessões expiram, e os sistemas anti-bot respondem a padrões, não a intenções, então uma técnica que funciona de um notebook pode não funcionar de um datacenter.
E a maior limitação não é técnica. O que você pode coletar, com que frequência e o que pode fazer depois com isso é decidido pelos termos do site, pelas diretivas robots e pela lei da sua jurisdição, e nada disso muda porque o código funciona.
A sequência de solução de problemas que decorre de tudo isso é curta. Quando uma execução de scraping não retorna nada, verifique primeiro o código de status, depois se o conteúdo está na resposta e, em seguida, se o seletor corresponde ao DOM renderizado, e não ao código-fonte. Só depois dessas três etapas o navegador deve ser considerado.
Perguntas frequentes
Preciso de uma biblioteca para fazer requisições HTTP no Node.js?
Não. O Node.js expõe a Fetch API como global, então o fetch fica disponível sem instalar nada, junto com o objeto de resposta e seus membros ok, status e text(). O que você precisa é de um parser, porque o fetch devolve uma string e a correspondência de strings em HTML quebra assim que a marcação muda.
Por que meu scraper retorna uma lista vazia de uma página que parece normal no navegador?
A causa mais provável é que a página é renderizada no cliente e os dados nunca estiveram na resposta HTTP. Confirme comparando o texto visível na resposta bruta com o que o navegador mostra e contando as tags script em relação ao conteúdo. Se a resposta for uma casca, vá para o endpoint JSON do site ou renderize a página em um navegador real.
O Cheerio substitui um navegador headless?
Não. O Cheerio analisa HTML e permite consultá-lo com seletores. Ele não executa JavaScript, então não consegue produzir conteúdo que a página gera após o carregamento. É a ferramenta certa para a primeira rota e a errada para a terceira, e recorrer a um navegador quando o Cheerio bastaria é o custo desnecessário mais comum em código de scraping.
Como saber se uma página é renderizada no servidor ou no cliente?
Faça a requisição da URL e olhe a resposta bruta, não o DOM renderizado. Se os valores que você quer estão no corpo da resposta, ela é renderizada no servidor e a rota barata funciona. Se o corpo contém um elemento raiz, pacotes de script e pouco texto, o conteúdo está sendo montado no navegador.
Como fazer scraping de uma página que exige login?
Faça login uma vez em um contexto de navegador, salve o estado de armazenamento em um arquivo e carregue esse estado em execuções posteriores. Trate o arquivo como segredo, espere que ele expire e prefira uma sessão que você tem autorização para usar. Se um alvo exige contornar um CAPTCHA ou uma verificação de propriedade, pare e use uma rota oficial.
O Playwright ou o Puppeteer é melhor para scraping?
Ambos controlam um navegador real e conseguem raspar as mesmas páginas. A decisão é sobre detalhes da biblioteca, como suporte a locators, comportamento de espera e bindings de linguagem, e não sobre rotas de acesso, e isso é abordado no nosso comparativo Playwright vs Puppeteer. Qualquer que você escolha, a decisão de rota deste artigo vem primeiro.
Quantas páginas posso raspar de uma vez?
Comece sequencial e meça antes de aumentar a concorrência. Requisições HTTP escalam muito mais barato do que contextos de navegador, e navegadores em paralelo na mesma máquina basicamente disputam a mesma CPU, além de dar ao site alvo um pico de tráfego. Para scraping HTTP, de quatro a oito em voo com um atraso é um ponto de partida mais seguro do que dezenas.
O que devo fazer quando recebo uma resposta 429?
Leia o cabeçalho Retry-After e espere pelo menos esse tempo, depois tente de novo com backoff exponencial até um limite pequeno e falhe de forma explícita depois disso. Um 429 é um sinal de taxa, não um erro para martelar em um loop apertado de tentativas, e ignorá-lo é como um endereço acaba na lista de bloqueio.
Fazer scraping é legal?
Depende do site, dos dados, da jurisdição e do que você faz com o resultado. Diretivas robots e termos de serviço declaram o que um site permite, e regras sobre dados pessoais e direitos sobre bancos de dados variam por país. Nada neste artigo é aconselhamento jurídico; verifique os termos e a lei aplicável antes de coletar qualquer coisa em escala.
Quando devo usar uma API oficial em vez de scraping?
Sempre que existir uma e ela cobrir os campos de que você precisa. Uma API documentada é um contrato estável, normalmente tem limites de taxa explícitos e não quebra quando o layout da página muda. O scraping é o recurso para dados publicados em um navegador sem caminho de acesso suportado, não o padrão.
Preciso de um agente de navegador para fazer scraping?
Apenas para tarefas que precisam de um estado de login real, de conteúdo que aparece após interação, de execução visível ou de uma intervenção humana no meio do fluxo. Para páginas que retornam seu conteúdo por HTTP, ou sites com uma API oficial, um agente de navegador adiciona custo sem adicionar capacidade.
Se você quiser experimentar a rota do agente de navegador em uma tarefa de scraping que realmente precise dela, o ego (lite) é gratuito para baixar, e as páginas de scraper de preços e de scraper de SERP descrevem dois trabalhos concretos de ponta a ponta.