JavaScript 网页抓取常常失败,问题不在代码写错,而在于一开始就选错了访问路线。如果数据本来就在初始 HTML 里,用 Node.js 的 fetch 加一个 HTML 解析器就够了。只有当页面必须先执行 JavaScript、翻页、点击或以其他方式交互,数据才会出现时,浏览器才成为必需品,而这正是静态 HTML 与渲染页面之间的分界线。
对于提前就已知、且会反复执行的工作流,Playwright 非常合适:打开页面、等待某个元素、点击控件、提取字段,然后一遍遍重跑同一条路径。问题出现在页面结构、翻页方式或交互流程发生变化,而那一串写死的选择器和操作开始失效的时候。
这时候,像 ego (lite) 这种由 Agent 驱动的浏览器就更合适。它不会假定原来的路径依然存在,Agent 可以检查当前渲染出来的页面,判断下一步该做什么,并在发生跳转或动态变化后继续稳定的执行下去。
JavaScript 爬虫能否跑通,真正取决于什么?
访问路线决定结果。同一个目标站点,可能用 HTTP 就能轻松抓下来,也可能对 HTTP 完全不可见,区别只在于数据是随初始 HTML 响应一起到达,还是之后由浏览器里的 JavaScript 拉取并渲染出来。
所以第一件事不是动手写爬虫,而是打开目标页面,查看源代码而不是渲染后的 DOM,搞清楚你要的字段到底存在哪里。本指南后面的所有内容,都从这个答案推导而来。
你的目标站点适合三条访问路线中的哪一条?
三条路线几乎覆盖了所有抓取任务,而且按成本排序。静态 HTML 最省、最快;页面本身就在调用的 JSON 接口,往往是你拿到的最干净的数据;真实浏览器能力最强,但在 CPU、内存和脆弱性上的代价也最高。
| 路线 | 能做到什么 | 做不到什么 |
|---|---|---|
| HTTP 请求 + HTML 解析器 | 直接抓取任意 URL,读取响应正文,再对返回的标记做查询。单进程每分钟可处理数千个页面,且不需要浏览器二进制文件。 | 无法运行页面脚本、点击、滚动或填写表单。在客户端渲染的页面上,它只会返回空壳,因为数据从来就不在响应里。 |
| 直接的 JSON 接口 | 直接返回结构化数据,无需解析标记,因此即使页面版式改版,字段名依然稳定。载荷最小,解析最快。 | 无法在站点更新后保持稳定。这类接口属于内部接口,没有文档,可能在毫无通知的情况下变更,或开始拒绝请求。 |
| 真实浏览器自动化 | 执行页面的 JavaScript,等待内容出现,并像真人一样与渲染后的结果交互。 | 无法低成本扩展。每个浏览器上下文都要占用实打实的内存,而要跑一大批浏览器,所需的基础设施远超一个 HTTP 循环。 |
在 Node.js 里如何抓取并解析静态 HTML?
先从平台本身入手。Node.js 把 Fetch API 作为全局对象提供,所以发请求完全不需要额外依赖。下面这段就是整条第一条路线:发请求、检查状态、读取文本,然后把标记交给解析器。
请求本身除了平台之外什么都不需要,因为 Fetch API 是 Node.js 的全局能力,所以一次普通的 GET 不需要安装任何 HTTP 库。
状态检查是最先被人删掉、也是事后最容易被忽略的一步。404 或反爬拦截页同样会返回正文,而这段正文会顺利解析出零个匹配元素,看上去和选择器写错了一模一样。
const res = await fetch(url, {
  headers: { "user-agent": "my-scraper/1.0 (+contact@example.com)" },
});

if (!res.ok) {
  throw new Error(`${res.status} ${res.statusText} for ${url}`);
}

const html = await res.text();
频率限制应该就写在这个循环里,而不是事后再补。请求之间加一个被 await 的延迟,既能让你这个小任务显得有礼貌,也能让 IP 地址免进黑名单:
const sleep = (ms) => new Promise((r) => setTimeout(r, ms));

for (const url of urls) {
  const html = await getHtml(url);
  await parse(html);
  await sleep(1000);
}
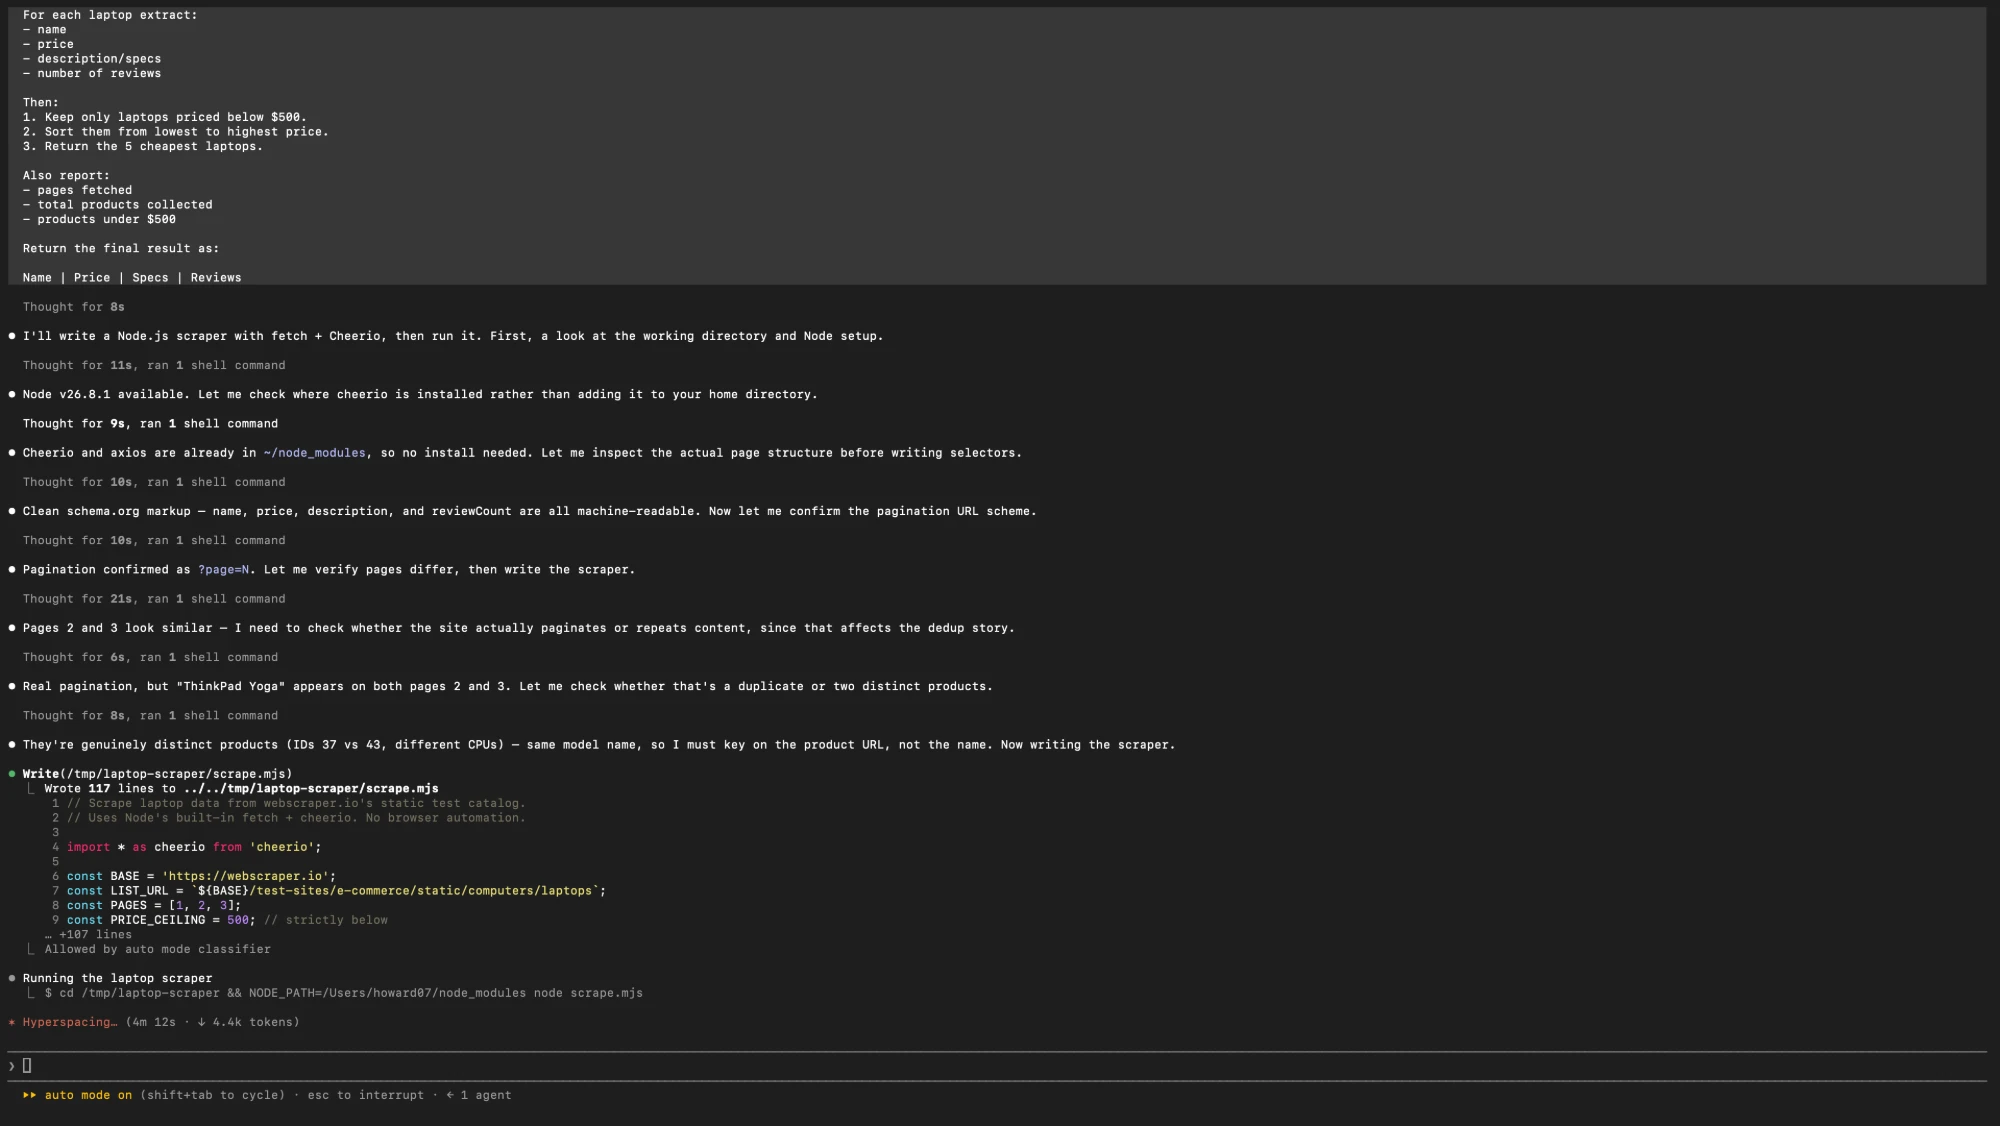
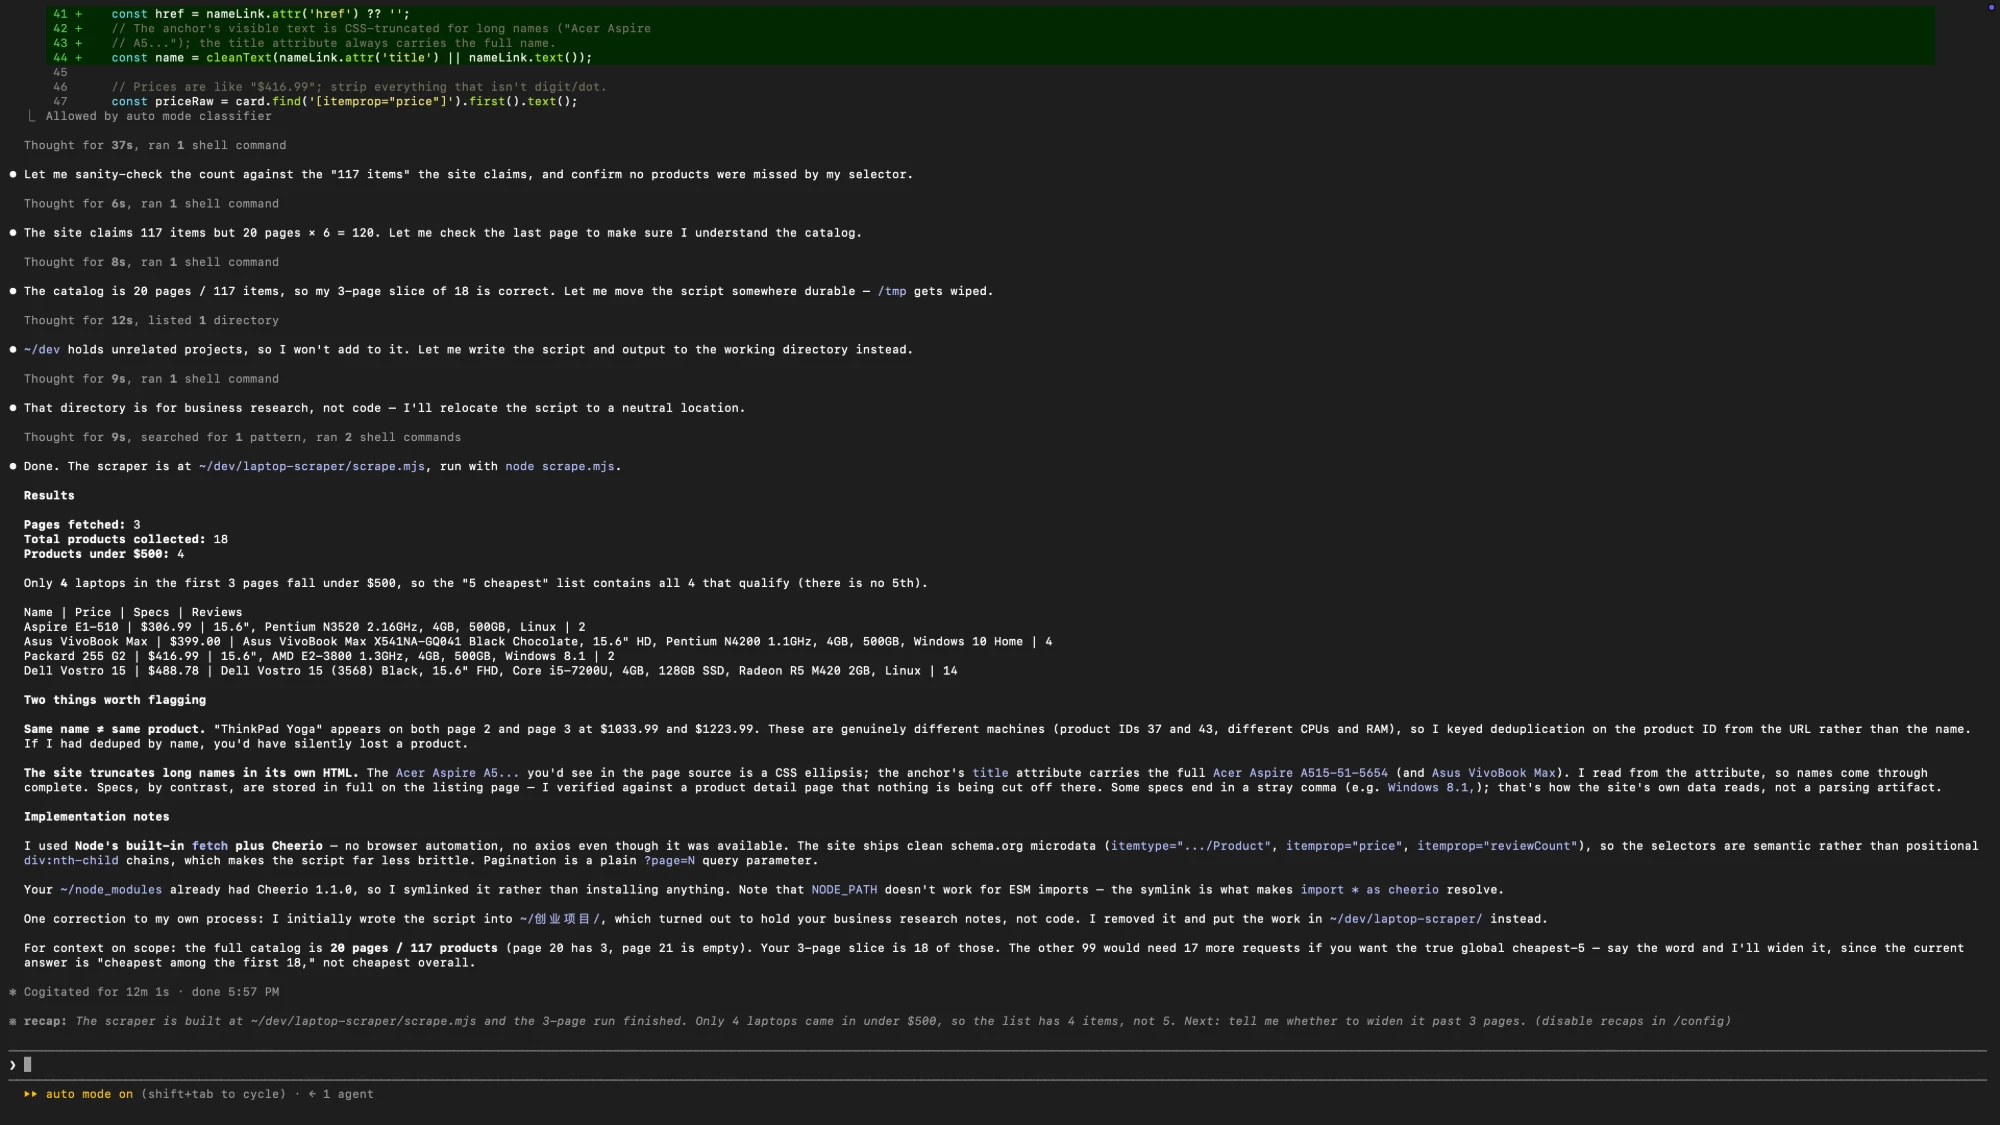
下面是第一条路线实际拿到的东西。下表是针对一个公开的笔记本电脑测试目录,用普通 HTTP 请求加选择器库得到的真实输出:没有浏览器,没有渲染步骤,三个页面就是三次静态响应。
| ID | 名称 | 价格 | 规格 | 评论数 |
|---|---|---|---|---|
| 32 | Aspire E1-510 | $306.99 | 15.6", Pentium N3520 2.16GHz, 4GB, 500GB, Linux | 2 |
| 45 | Asus VivoBook Max | $399 | 15.6" HD, Pentium N4200 1.1GHz, 4GB, 500GB, Windows 10 Home | 4 |
| 31 | Packard 255 G2 | $416.99 | 15.6", AMD E2-3800 1.3GHz, 4GB, 500GB, Windows 8.1 | 2 |
| 46 | Dell Vostro 15 | $488.78 | 15.6" FHD, Core i5-7200U, 4GB, 128GB SSD, Radeon R5 M420 2GB, Linux | 14 |
十八款产品里有四款低于 $500。这就是第一条路线在这份目录上的全部结果:三次请求,没有渲染,没有浏览器进程。而诚实的一面也从这里开始,因为这张表里少了一样读者本以为会看到的东西。
Cheerio、DOMParser、jsdom:该选哪个解析器?
这三者常被拿来比较,仿佛是可以互换的库。其实不是,因为它们承诺的东西不同:其中两个只是解析标记供查询,另一个则实现了带脚本执行的 DOM。
本指南所依赖的解析器,文档在 cheerio.js.org,其中明确指出 Cheerio 只解析并查询标记,不会执行页面脚本。
| 选项 | 能做到什么 | 做不到什么 |
|---|---|---|
| Cheerio | 快速解析 HTML 字符串,并用 jQuery 风格的选择器查询。依赖小、不需要浏览器,非常适合从响应正文里抽取几百个字段。 | 无法运行页面脚本、渲染组件或处理布局。它只解析标记,行为并不像浏览器。 |
| jsdom | 在 Node.js 里提供一套 DOM 实现,带有 document、window 和脚本执行能力,让针对浏览器 API 写的代码可以原样运行。 | 无法在渲染或还原度上媲美真实浏览器,而且每个页面的负担重得多。它是 DOM 的替代品,不是 Chrome。 |
| DOMParser | 用浏览器内置 API 把字符串变成一个可查询的 document,项目完全不需要新增依赖。 | 不能被 await:它是同步且阻塞的,而且在 Node.js 里直到较新的版本才成为全局对象。 |
用 Cheerio 读取数据走的是熟悉的选择器 API。注意提取文本时要在两端做 trim,因为抓来的标记带着缩进和换行,不处理就会混进数据集里:
import * as cheerio from "cheerio";

const $ = cheerio.load(html);
const items = $(".product-card").map((i, el) => ({
  name: $(el).find(".name").text().trim(),
  price: $(el).find(".price").text().trim(),
})).get();
用 DOMParser 做同样的提取则是这样,而且只有在该全局对象存在的地方才能运行:
const doc = new DOMParser().parseFromString(html, "text/html");
const rows = [...doc.querySelectorAll("table tbody tr")].map((tr) => ({
  cells: [...tr.querySelectorAll("td")].map((td) => td.textContent.trim()),
}));
如何找到页面本身已经在用的 JSON 接口?
在写第一个选择器之前,先打开浏览器的网络面板,筛选 fetch 和 XHR,重新加载页面,看看返回了什么。很多数据驱动的站点只是用少量 JSON 响应拼出可见页面,而这些 JSON 比标记好消费得多。
找到之后,这个请求通常需要页面当时发送的同一批请求头,有时还需要会话 Cookie。直接用网络面板的 copy-as-fetch 输出重放它,不要手动拼装。
const res = await fetch("https://example.com/api/listings?page=1", {
  headers: { accept: "application/json" },
});

if (!res.ok) throw new Error(`${res.status} for listings page 1`);

const { items } = await res.json();客户端渲染的页面为什么会返回空壳?
客户端渲染的页面发回来的标记里几乎没有内容。初始响应里只有一个根元素、一包 script,也许还有一个加载状态。用户在屏幕上看到的文字,是响应到达之后由 JavaScript 生成的,所以只读响应的 HTTP 请求根本无从读起。
这并不神秘,是可以诊断的。两个检查就能覆盖大多数情况:响应里的可见文本只是浏览器所显示内容的一小部分,而且标记中绝大多数是 script 标签:
const text = html.replace(/<script[\s\S]*?<\/script>/g, "").replace(/<[^>]+>/g, " ").replace(/\s+/g, " ").trim();

console.log({
  textLength: text.length,
  scriptCount: (html.match(/<script\b/g) ?? []).length,
  hasRoot: /id="(root|app|__next)"/.test(html),
});
文本很短、script 很多、根 div 又是空的,这三者同时出现,说明老实该走第三条路线了。而只有几十个字符、完全没有 script 标签,通常意味着更简单的问题:请求被拦截了,或者你请求了错误的 URL。
实际差别大致如下:
| HTTP 响应中的信号 | 通常意味着 | 下一步 |
|---|---|---|
| 内容完整、标记真实 | 服务端已经渲染好了页面,不需要再做别的。 | 用选择器库解析即可。 |
| 根 div 加大量 script | 客户端渲染,内容在响应之后才到达。 | 去找 JSON 接口,或者渲染这个页面。 |
| 文本极短,没有 script | 被拦截、被重定向,或者干脆是 URL 错了。 | 解析之前,先记录状态码、最终 URL 和请求头。 |
Playwright 如何抓取真实浏览器里的页面?
Playwright 驱动的是真实浏览器,页面会像面对普通访客那样完整执行。抓取的大致形态比多数人想象的更简单:打开一个上下文、访问 URL、等待你真正需要的那个东西出现,然后把它读出来。
本文用到的 API 文档在 playwright.dev,这是启动浏览器、上下文和 locator 的权威参考。
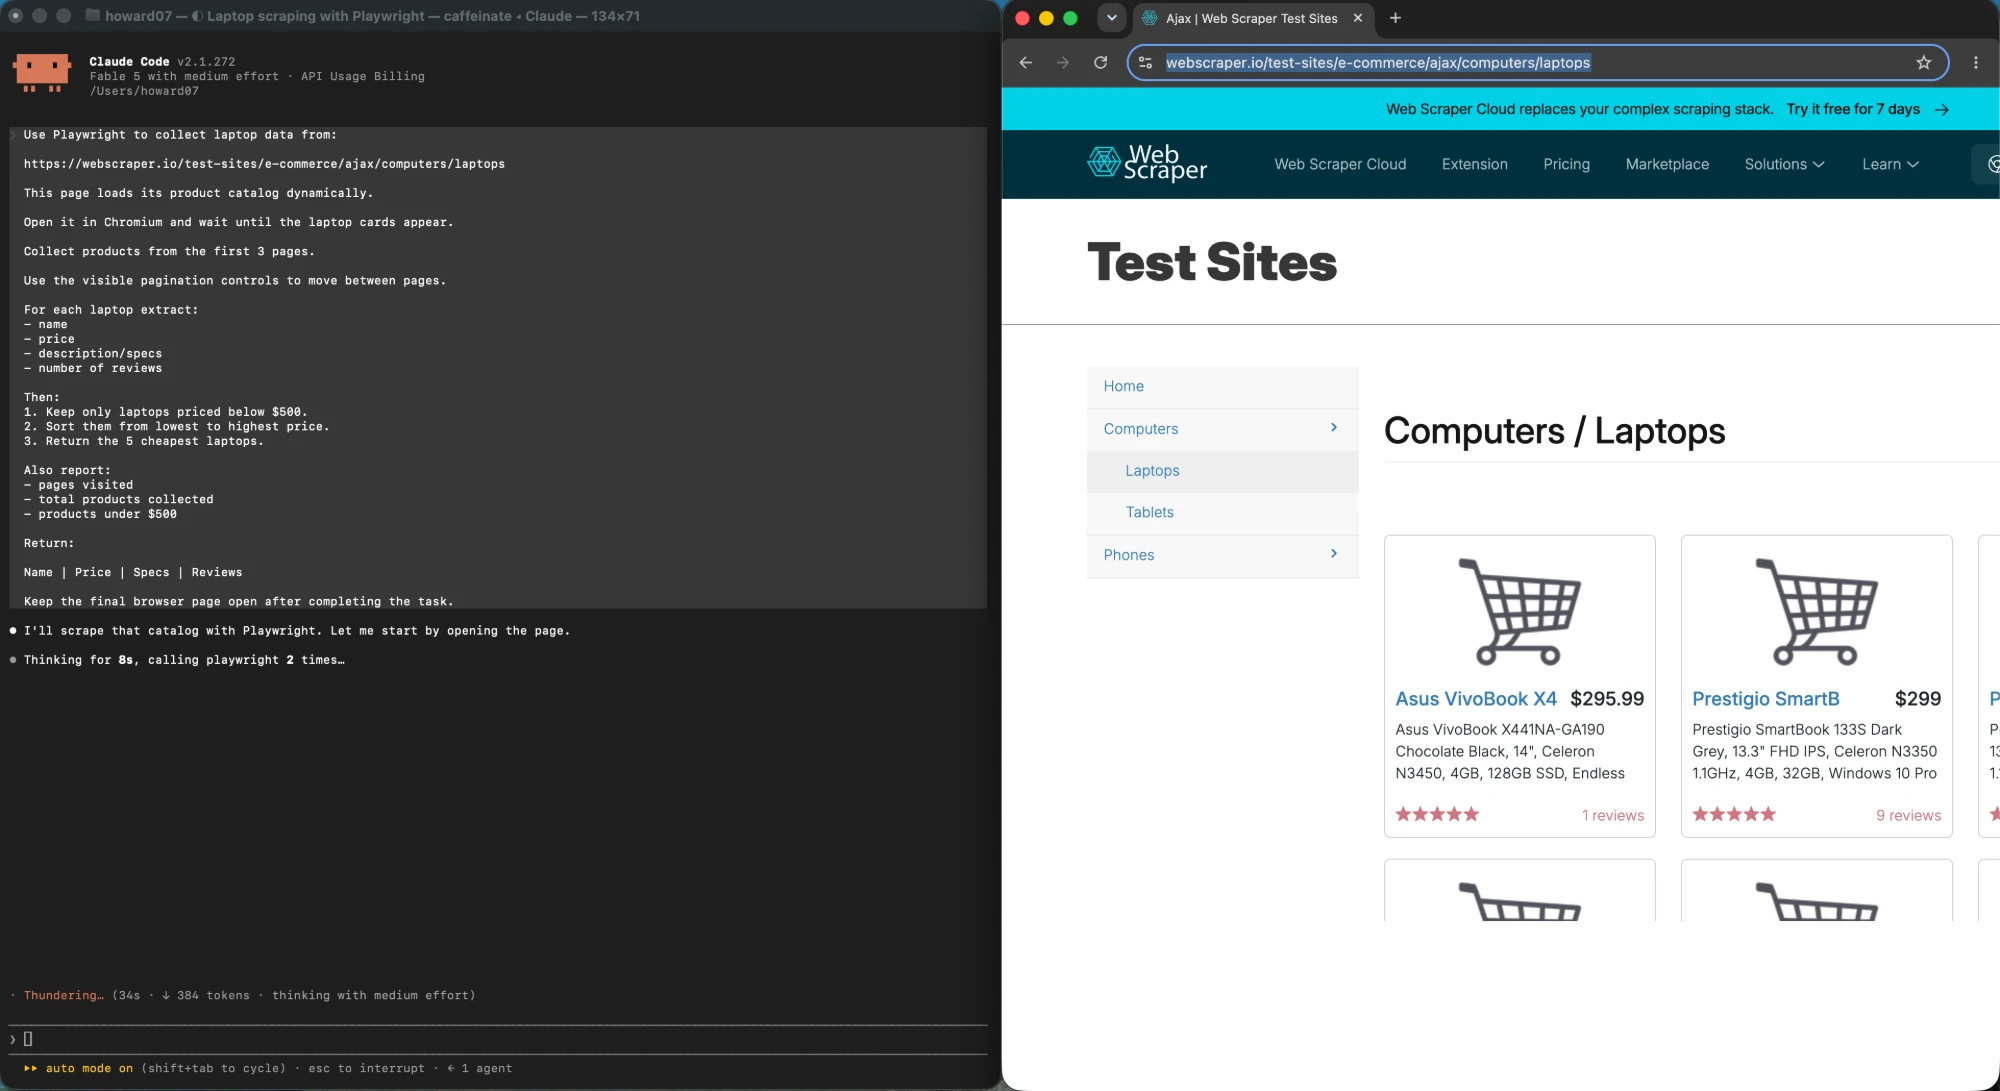
下面这个读取模式先等待一个选择器,然后通过 page.evaluate 提取,后者会在页面内部执行你的函数,并返回可序列化的结果:
import { chromium } from "playwright";

const browser = await chromium.launch();
const context = await browser.newContext();

try {
  const page = await context.newPage();
  await page.goto(url, { waitUntil: "domcontentloaded" });
  await page.waitForSelector(".product-card");

  const rows = await page.evaluate(() =>
    [...document.querySelectorAll(".product-card")].map((el) => ({
      name: el.querySelector(".name")?.textContent?.trim() ?? null,
      price: el.querySelector(".price")?.textContent?.trim() ?? null,
    })),
  );

  console.log(rows);
} finally {
  // contexts hold the memory; close it even when the scrape throws
  await context.close();
  await browser.close();
}
有两个生命周期细节比选择器更值得注意。第一,上下文是廉价、可一次性丢弃的单位,所以一个浏览器可以服务多次相互隔离的运行,每次结束时都要 close。第二,在页面上提取文本拿到的是文本节点,而不是渲染后的值:被 CSS 隐藏的内容依然在 DOM 里,也依然会出现在你的输出中。
当目标只是某个特定元素而不是整个列表时,locator 是更干净的读取路径。Playwright 自己的 locator 文档就指出,按钮、链接和输入框并不需要先等待再点击,这一点值得记住,免得把每一次交互都套上一层显式等待:
const title = await page.getByRole("heading", { level: 1 }).innerText();
const price = await page.locator("[data-testid=price]").innerText();
会话、封禁风险与验证码(CAPTCHA)会如何改变方案?
目标一旦需要登录,抓取就不再是单纯的数据活,而变成了会话管理问题。Playwright 直接支持这一点:认证一次,把浏览器的存储状态保存到文件,之后的运行复用即可,不必每次都写一遍凭据输入流程。
// once, interactively
await context.storageState({ path: "auth.json" });

// later runs
const context = await browser.newContext({ storageState: "auth.json" });
由此引出两个运维事实。保存下来的会话状态本身就是凭据,应该放进密钥仓库,而不是提交到代码仓库。而且保存的会话会过期,所以某次运行突然开始返回登录页,那是会话问题,不是选择器问题。
让这个状态在多次启动之间保持存活是另一个话题: 跨 Agent 运行复用持久浏览器会话 有详细讲解。
就自动化流量而言,三个约束决定了你做的是一件抓取工作,还是一场注定要输的仗:站点的 robots 指令和服务条款允许什么,站点公布或能容忍多高的请求频率,以及你拿到的响应是内容本身还是一张挑战页。这些都是在写代码之前就要定的策略问题,我们的另一篇指南有更深入的讨论:登录墙后的抓取。
JavaScript 爬虫在生产环境里会栽在哪里?
爬虫很少是因为选择器写错而失败。它们往往死在第二次运行、第一百个 URL 上:页面变慢了、响应变成重定向了,或者站点开始限流了。修复手段都不光鲜,而且很具体。
async function getWithRetry(url, attempt = 0) {
  const res = await fetch(url);
  if (res.status === 429 || res.status >= 500) {
    if (attempt >= 3) throw new Error(`giving up on ${url}`);
    const retryAfter = Number(res.headers.get("retry-after"));
    const waitMs = Number.isFinite(retryAfter)
      ? retryAfter * 1000
      : 2 ** attempt * 1000;
    await new Promise((r) => setTimeout(r, waitMs));
    return getWithRetry(url, attempt + 1);
  }
  if (!res.ok) throw new Error(`${res.status} for ${url}`);
  return res.text();
}
第二个陷阱是并发。同一台机器上十个并行浏览器上下文,大多只是在抢同一批 CPU,所以吞吐量的提升小于内存代价,而站点看到的是一阵突发流量,而不是细水长流。先串行跑,测出数据,只有在目标站点受得了的情况下才把数字往上调。
第三点,任何读取无承诺接口的爬虫都需要兜底。把基于选择器的可见页面解析保留在代码里,让失败的 JSON 调用回落到它上面,这样上游悄无声息的变更只会让这次运行降级,而不是结果全空。
什么情况下才真的必须用真实浏览器?
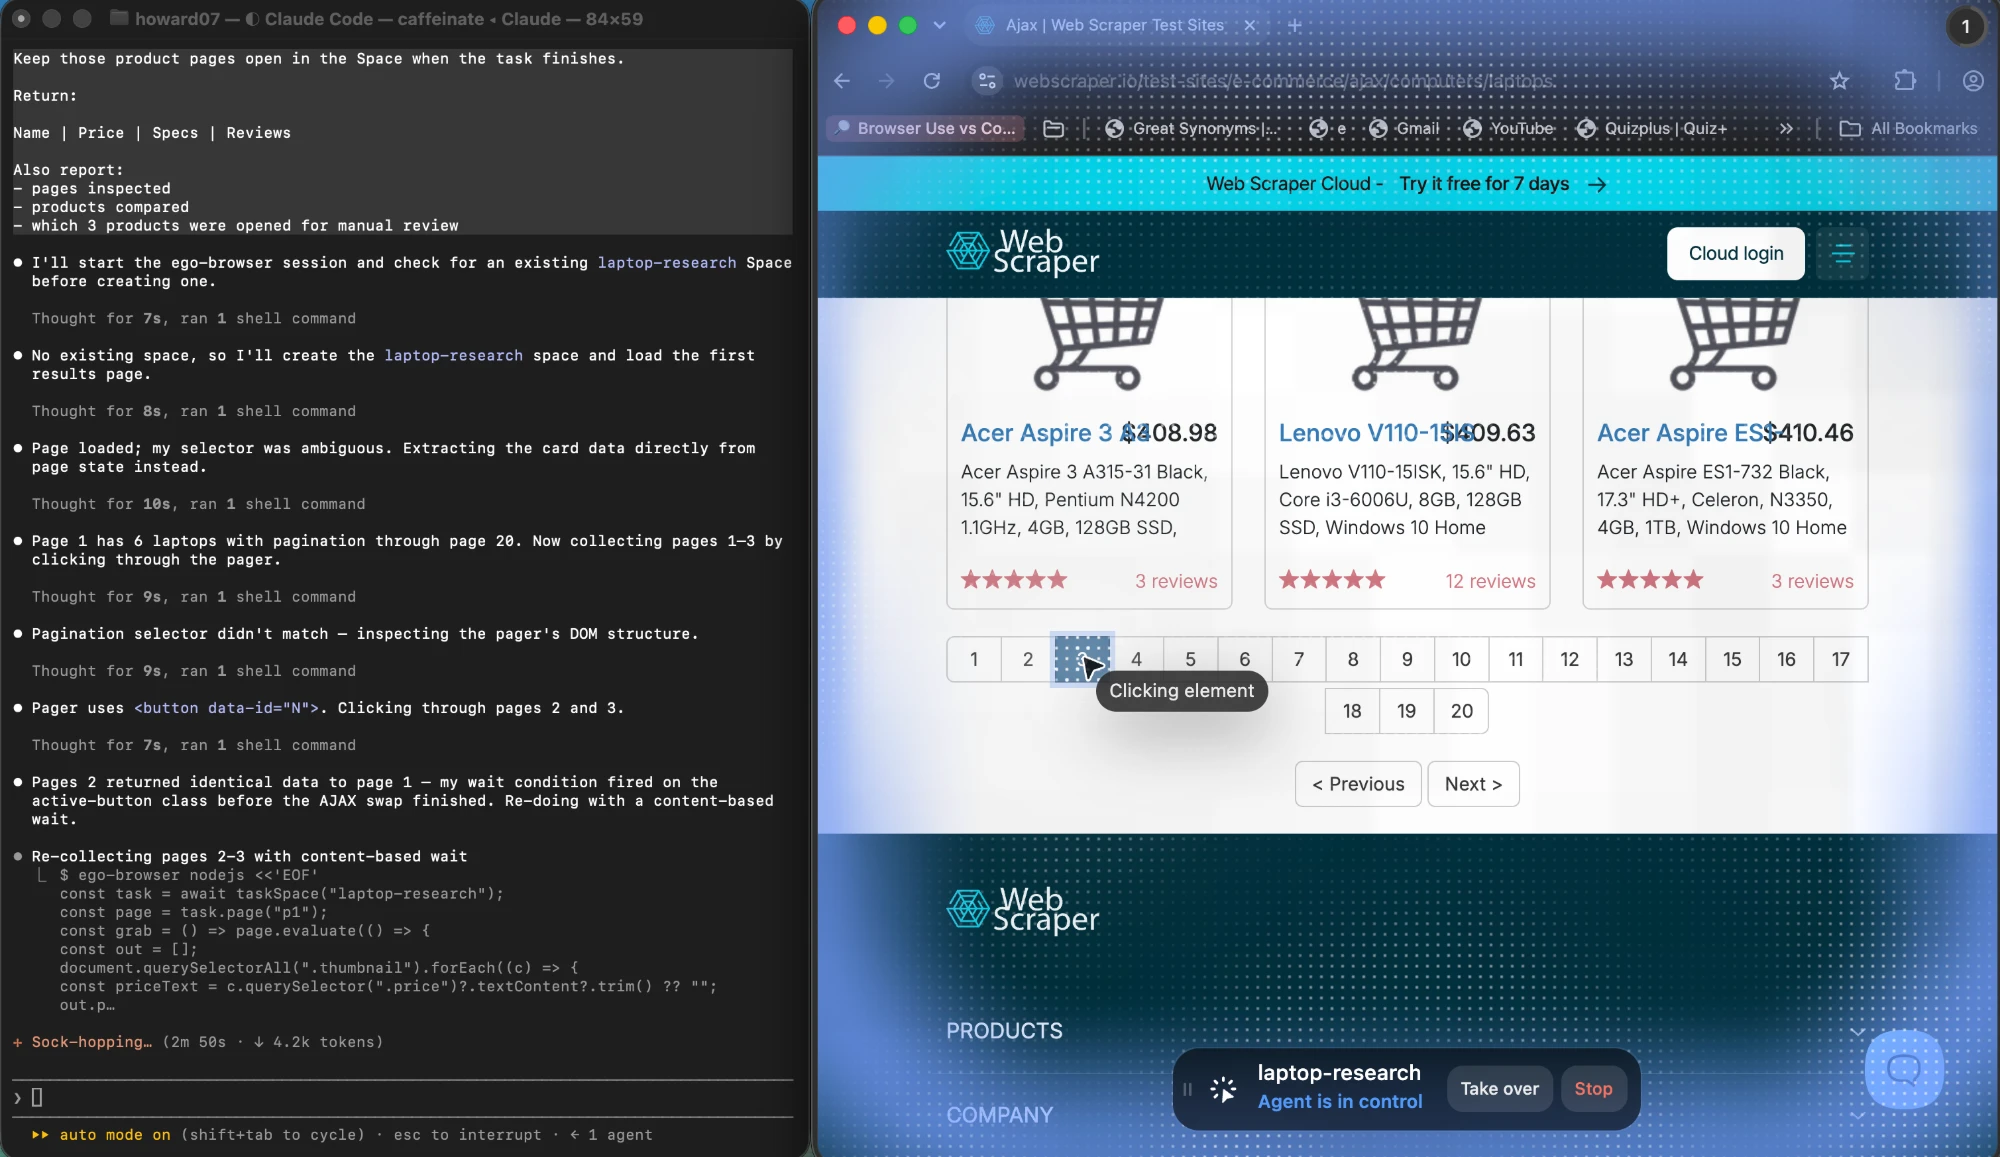
当任务需要只有浏览器才能提供的条件时,真实浏览器才是正确答案:你机器上已经存在的已认证会话、只有交互后才会出现的内容、中途必须由人介入的流程,或者需要实时盯着看而不是一次性抓取的结果。除此之外,用 HTTP 加解析器都更快、更省,也更容易长期稳定运行。
无头浏览器和真实浏览器之间的取舍,见 面向 AI Agent 的无头浏览器与真实浏览器对比。
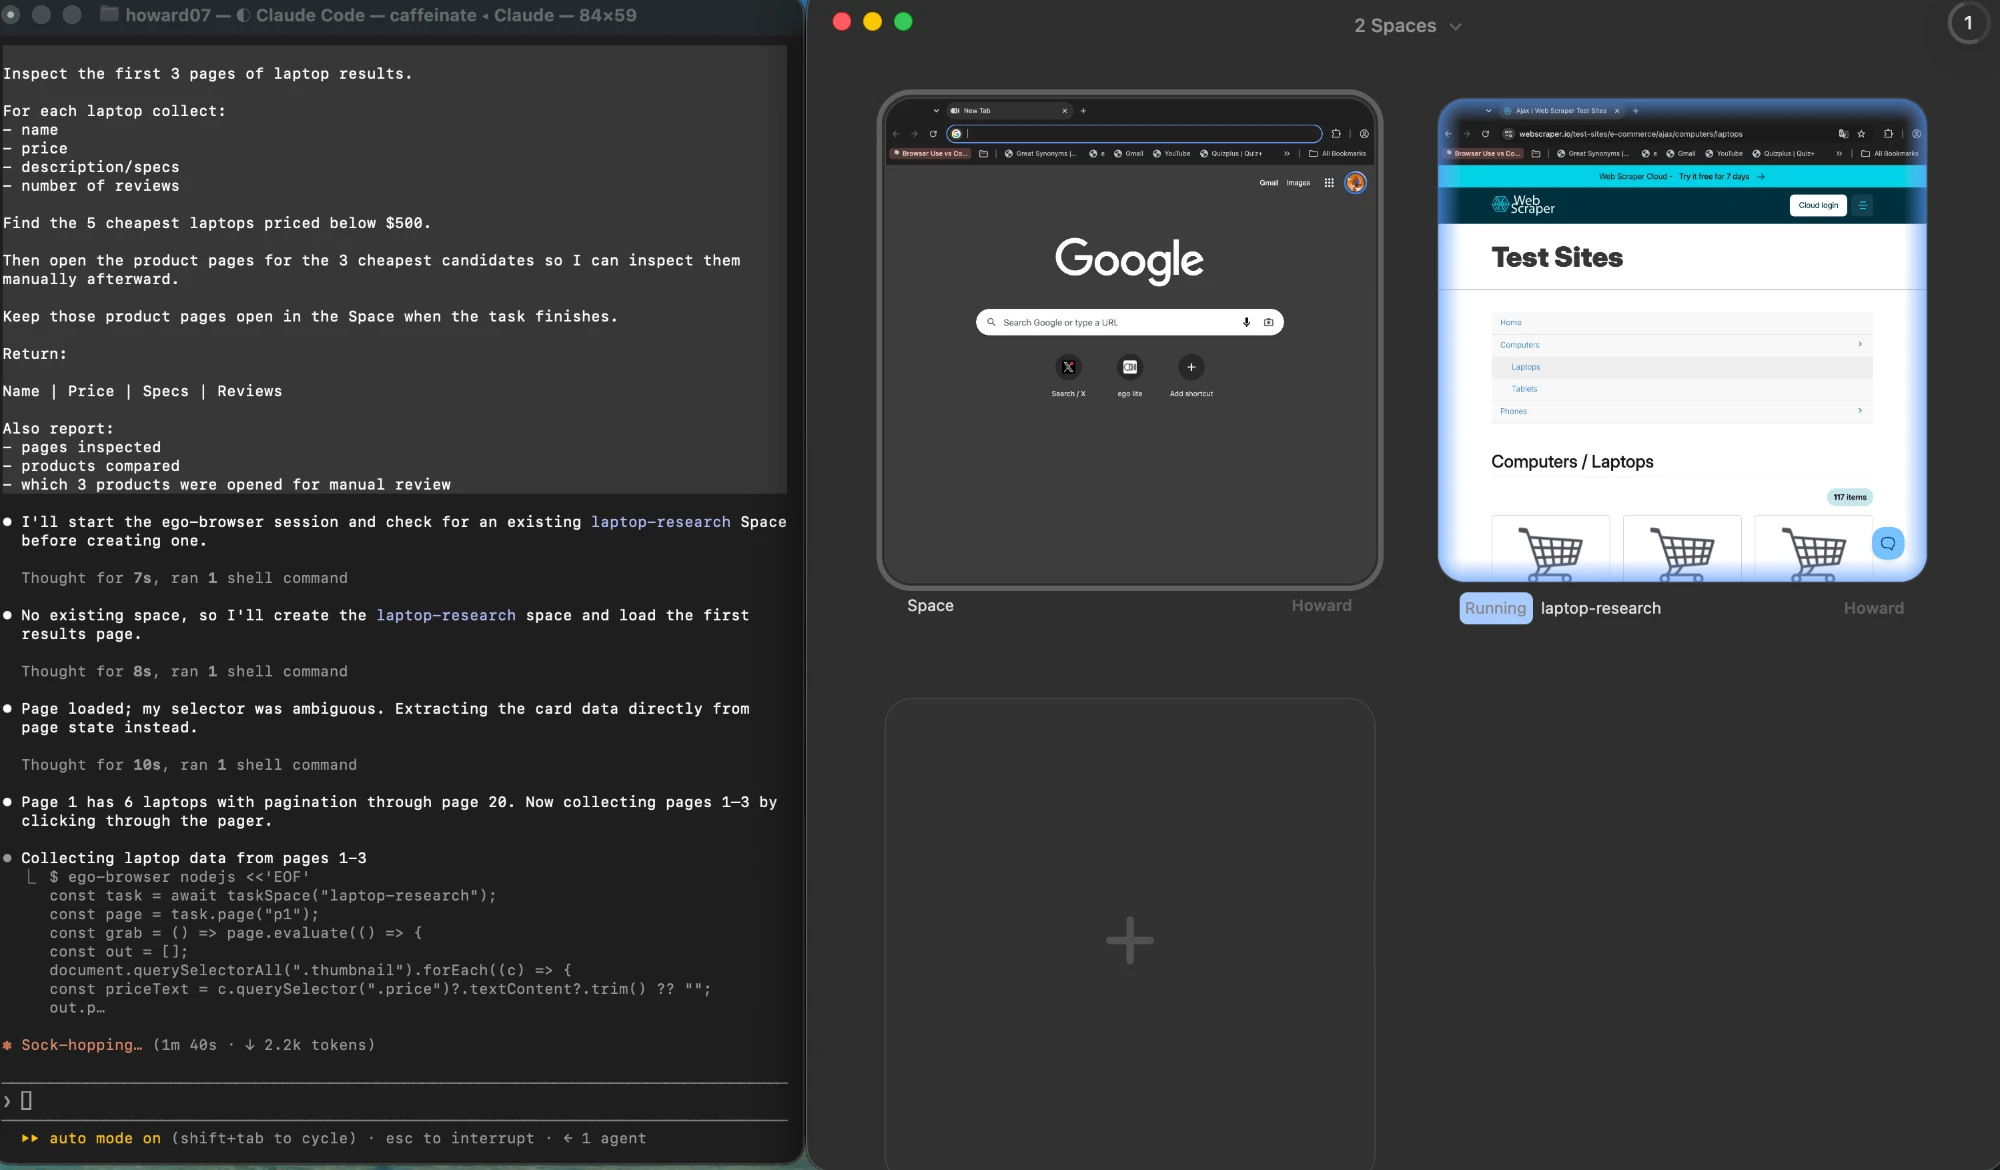
这种情况下,由任务驱动的浏览器 Agent 才值得引入。 ego (lite) 是为 Agent 驱动的工作而打造的浏览器:你描述目标,它在真实浏览器里执行,包括你本来就开着的已登录会话,并提供一个可见的界面,在某个步骤需要人来判断时由你接手。对于需要真实登录态、动态页面、可见执行过程或人工交接的抓取任务,它省掉了上文说的那一整套会话接线工作。它不是 Playwright 的替代品,也不对每个站点做出承诺:那些用挑战页回应的页面,或禁止自动化访问的页面,对它来说和其他任何路线一样不可触碰。当普通 HTTP 请求或官方 API 已经能返回你需要的东西时,再引入浏览器 Agent 只会让任务更慢。
当浏览器确实成为唯一答案之后,若想更深入地比较浏览器工具链,可以看我们的 Playwright 与 Puppeteer 抓取对比详解 讲的是库本身怎么选,而 AI 网页抓取工作流 则讲 Agent 在抓取流水线中的位置。
主要有哪些挑战与限制?
这套框架里的每条路线都有无法靠工程手段消除的失效模式,提前了解它们,正是一个能跑一年的爬虫和一个只跑一周的爬虫之间的分水岭。
静态解析会在站点改版标记时失效。它没有能力察觉这种变化,所以某个字段悄悄变成 null,比直接崩溃更常见。每次运行都要校验样本,不要盲信流水线。
内部 JSON 接口会毫无预警地失效,它们是任何站点里承诺最少的部分。今天运行成功,并不能证明下个月还行。
浏览器自动化最贴近真实用户,但在规模上最脆弱。内存随并发增长,会话会过期,反爬系统针对的是行为模式而不是你的意图,所以笔记本上能用的手法,放到数据中心未必管用。
而最大的限制并不在技术层面。你被允许收集什么、多久收一次、拿到之后又能做什么,是由站点条款、robots 指令和你所在司法辖区的法律决定的,这些都不会因为代码跑通了而有任何改变。
由此得出的排查顺序很短。抓取返回空结果时,先看状态码,再看内容到底有没有出现在响应里,最后看你的选择器匹配的是渲染后的 DOM 还是源代码。这三步都走完,才应该考虑动用浏览器。
常见问题
在 Node.js 里发 HTTP 请求需要装库吗?
不需要。Node.js 把 Fetch API 作为全局对象提供,所以不安装任何东西就能用 fetch,连同 response 对象及其 ok、status、text() 成员。你真正需要的是一个解析器,因为 fetch 返回的是字符串,而用字符串匹配去处理 HTML,标记一改就会失效。
页面在浏览器里看着正常,为什么爬虫却返回空列表?
最可能的原因是页面为客户端渲染,数据从来就不在 HTTP 响应里。确认方法是对比原始响应中的可见文本与浏览器显示的内容,并统计 script 标签相对于内容的比例。如果响应就是个空壳,那就改用站点的 JSON 接口,或者用真实浏览器渲染页面。
Cheerio 能替代无头浏览器吗?
不能。Cheerio 解析 HTML,让你用选择器查询。它不执行 JavaScript,因此无法产出页面加载之后才生成的内容。它是第一条路线的正确工具,也是第三条路线的错误工具,而明明 Cheerio 够用却去上浏览器,是抓取代码里最常见的不必要开销。
怎么判断一个页面是服务端渲染还是客户端渲染?
请求这个 URL,看原始响应而不是渲染后的 DOM。如果你要的值就出现在响应正文里,说明是服务端渲染,走便宜的那条路线即可。如果正文里只有一个根元素、几包 script 和很少的文本,那内容是在浏览器里拼装出来的。
需要登录的页面怎么抓?
在浏览器上下文里登录一次,把存储状态保存到文件,之后的运行加载该状态。这个文件要当作密钥保管,并预期它会过期,同时只使用你有权使用的会话。如果目标要求绕过验证码或所有权校验,请停下来改用官方渠道。
抓取用 Playwright 还是 Puppeteer 更好?
两者都驱动真实浏览器,也能抓取同样的页面。这个决定取决于 locator 支持、等待行为、语言绑定等库层面的细节,而不取决于访问路线,我们的 Playwright 与 Puppeteer 对比。无论你选哪个,本文讲的路线决策都要先做。
一次能抓多少个页面?
先串行跑并测量,再考虑提高并发。HTTP 请求的扩展成本远低于浏览器上下文,而同一台机器上并行的浏览器大多只是在抢同一批 CPU,同时给目标站点送去一阵突发流量。做 HTTP 抓取时,同时在途四到八个、并带一个延迟,比一上来就几十个更稳妥。
收到 429 响应该怎么办?
读取 Retry-After 响应头,至少等待那么久,然后以指数退避重试,重试次数设一个较小的上限,超过就明确报错。429 是一个频率信号,不是在紧凑重试循环里硬砸过去的错误,忽视它正是 IP 地址最后进黑名单的原因。
抓取合法吗?
这取决于站点、数据、司法辖区以及你拿结果做什么。robots 指令和服务条款说明了站点的许可范围,而关于个人数据和数据库权利的规定因国家而异。本文不构成法律建议;在规模化收集任何数据之前,请先核对条款和适用法律。
什么时候该用官方 API 而不是抓取?
只要存在、且覆盖你需要的字段,就该用它。有文档的 API 是稳定的契约,通常有明确的频率限制,也不会因为页面版式变化而失效。抓取只是当数据发布在浏览器里、又没有受支持的访问途径时的兜底方案,不是默认选项。
做抓取需要浏览器 Agent 吗?
只有当任务需要真实登录态、交互后才出现的内容、可见的执行过程,或流程中途由人接管时才需要。对于能通过 HTTP 直接返回内容的页面,或已有官方 API 的站点,浏览器 Agent 只会增加成本,不会增加能力。
如果你想在一个确实需要的抓取任务上试试浏览器 Agent 路线,ego (lite) 可以免费下载,而 价格抓取 和 SERP 抓取 两个页面则完整拆解了两个具体场景。