
Il web scraping in JavaScript spesso fallisce non perché il codice sia sbagliato, ma perché è stato scelto il percorso di accesso sbagliato. Se i dati sono già nell'HTML iniziale, bastano fetch di Node.js e un parser HTML. Un browser diventa necessario solo quando la pagina deve eseguire JavaScript, paginare, fare clic o interagire in altro modo prima che i dati compaiano, che è la linea di demarcazione tra HTML statico e pagine renderizzate.
Playwright è la scelta ideale per flussi di lavoro noti in anticipo e ripetuti spesso: aprire la pagina, attendere un elemento, fare clic su un controllo, estrarre i campi e ripetere lo stesso percorso. I problemi iniziano quando cambiano la struttura della pagina, la paginazione o il flusso di interazione, e una sequenza fissa di selettori e azioni comincia a rompersi.
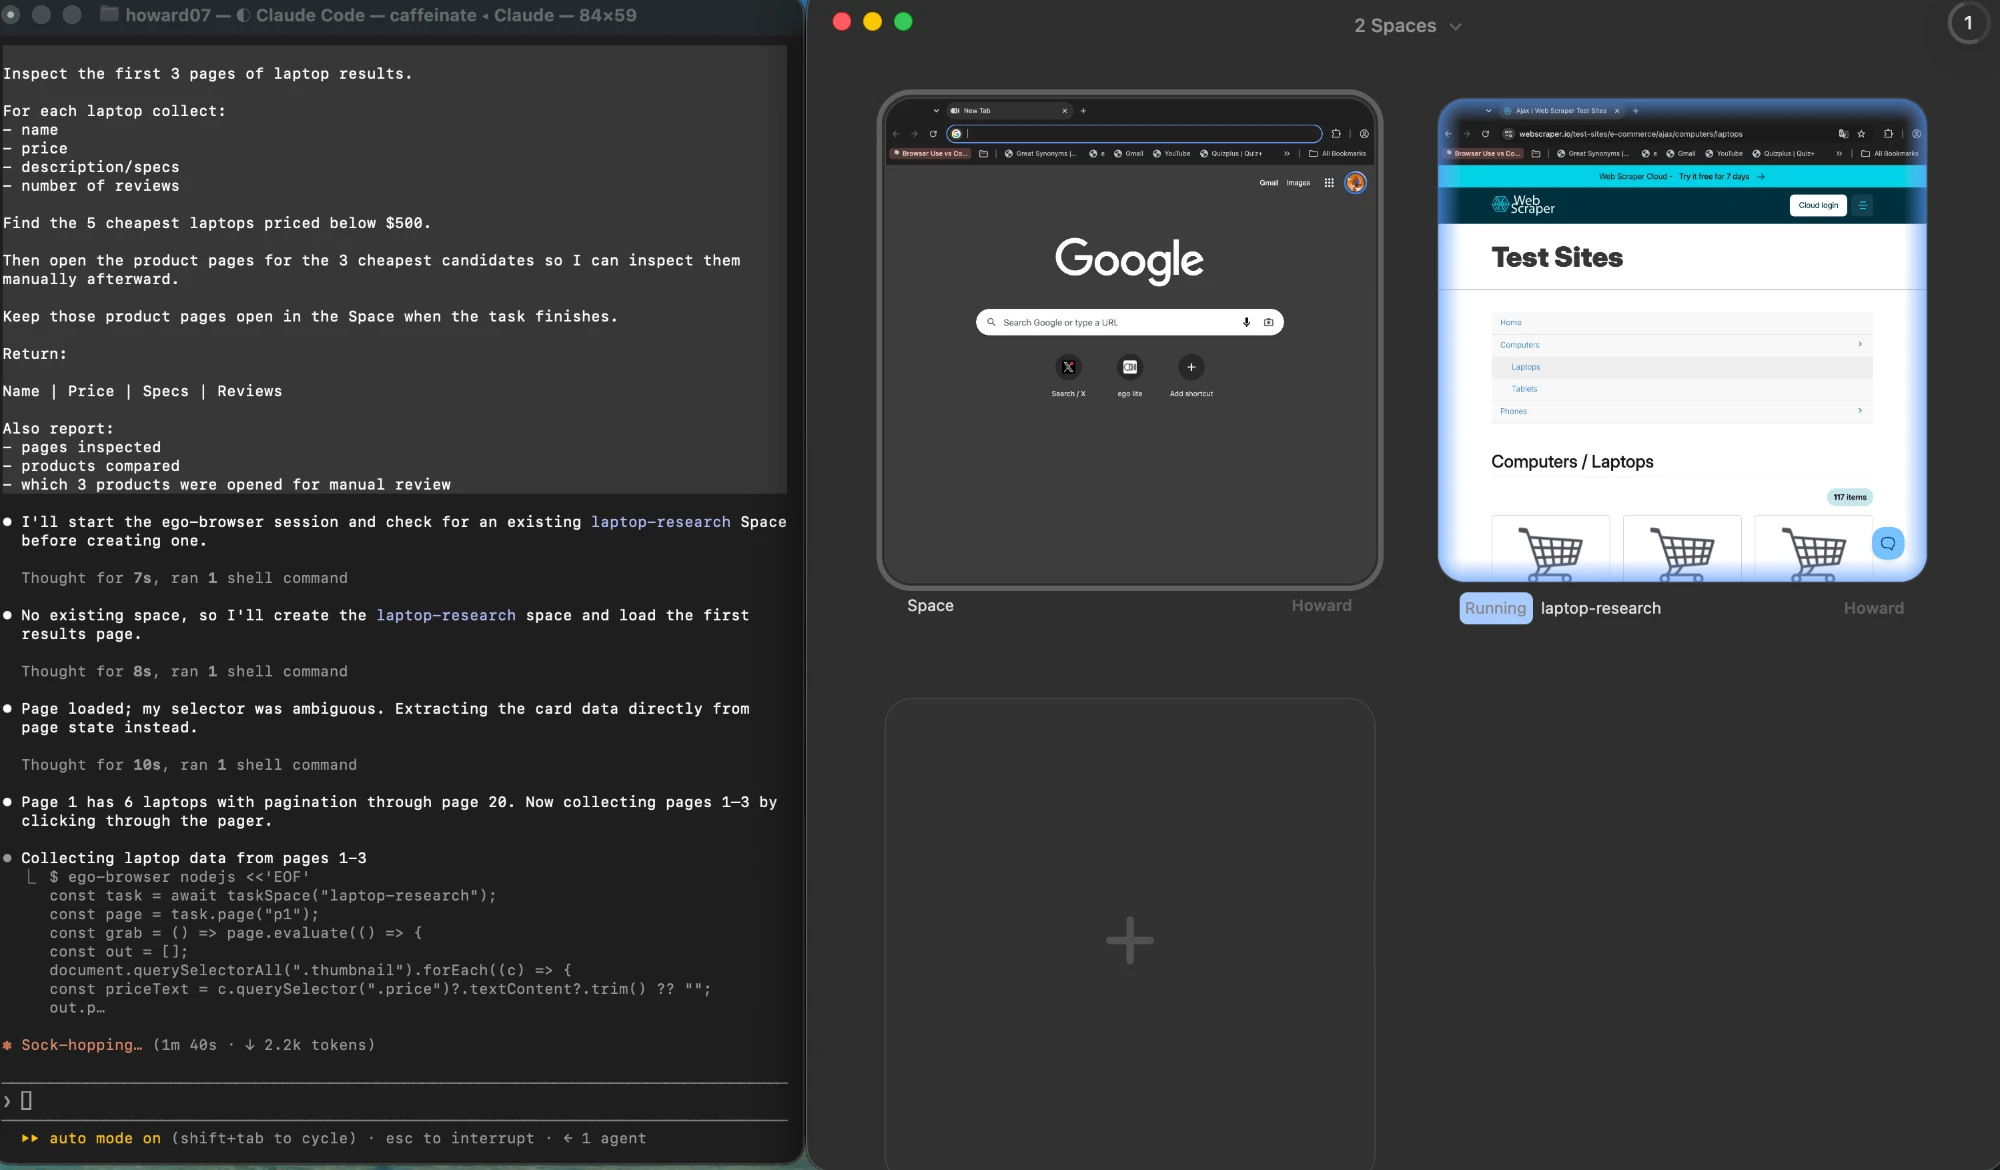
È qui che un browser guidato da un agente come ego (lite) si adatta meglio. Anziché dare per scontato che il percorso originale esista ancora, l'agente può esaminare la pagina attualmente renderizzata, decidere il passo successivo e continuare a operare in modo affidabile dopo una navigazione o un cambiamento dinamico.
Che cosa determina davvero se uno scraper JavaScript funziona?
È il percorso di accesso a decidere il risultato. Lo stesso sito di destinazione può essere banalmente estraibile via HTTP o del tutto opaco all'HTTP, a seconda che i dati arrivino nella risposta HTML iniziale oppure vengano recuperati e disegnati in seguito da JavaScript in esecuzione nel browser.
Quindi il primo compito non è scrivere uno scraper. È aprire la pagina di destinazione, guardare il codice sorgente invece del DOM renderizzato e scoprire dove risiedono davvero i valori che ti servono. Tutto il resto di questa guida discende da quella risposta.
Quale dei tre percorsi di accesso richiede il tuo obiettivo?
Tre percorsi coprono quasi ogni attività di scraping e sono ordinati per costo. L'HTML statico è il più economico e il più veloce. Un endpoint JSON che la pagina già chiama è spesso il dato più pulito che puoi ottenere. Un browser reale è il più potente e il più costoso in termini di CPU, memoria e fragilità.
| Percorso | Cosa può fare | Cosa non può fare |
|---|---|---|
| Richiesta HTTP + parser HTML | Recupera qualsiasi URL direttamente, legge il corpo della risposta e interroga il markup restituito. Elabora migliaia di pagine al minuto per processo e non richiede alcun binario del browser. | Non esegue gli script della pagina, non fa clic, non scorre e non compila moduli. Su una pagina renderizzata lato client restituisce il guscio vuoto, perché i dati non sono mai stati nella risposta. |
| Endpoint JSON diretto | Restituisce dati strutturati senza analizzare il markup, così i nomi dei campi sopravvivono ai rifacimenti del layout della pagina. Payload più piccolo, analisi più veloce. | Non resta stabile tra un aggiornamento e l'altro del sito. Questi endpoint sono interni, non documentati e possono cambiare o iniziare a rifiutare le richieste senza preavviso. |
| Automazione con browser reale | Esegue il JavaScript della pagina, attende la comparsa del contenuto e interagisce con il risultato renderizzato esattamente come farebbe una persona. | Non scala a basso costo. Ogni contesto del browser consuma memoria reale e una flotta di contesti richiede più infrastruttura di un ciclo HTTP. |
Come si recupera e si analizza l'HTML statico in Node.js?
Parti dalla piattaforma. Node.js espone l'API Fetch come globale, quindi una richiesta non richiede alcuna dipendenza. Lo schema qui sotto è l'intero primo percorso: effettua la richiesta, controlla lo stato, leggi il testo e poi affida il markup a un parser.
La richiesta in sé non richiede nulla oltre alla piattaforma, perché l'API Fetch è inclusa come globale di Node.js, quindi una semplice GET non ha alcuna libreria HTTP da installare.
Il controllo dello stato è la parte che si tende a eliminare per prima ed è quella che manca di più. Una pagina 404 o una pagina di blocco bot restituisce comunque un corpo, e quel corpo viene analizzato senza errori in zero elementi corrispondenti, un risultato che sembra esattamente un bug del selettore.
const res = await fetch(url, {
  headers: { "user-agent": "my-scraper/1.0 (+contact@example.com)" },
});

if (!res.ok) {
  throw new Error(`${res.status} ${res.statusText} for ${url}`);
}

const html = await res.text();
La limitazione di frequenza va inserita nello stesso ciclo, non aggiunta dopo. Una pausa attesa tra una richiesta e l'altra mantiene educato un lavoro di piccole dimensioni e tiene il tuo indirizzo fuori dalle liste di blocco:
const sleep = (ms) => new Promise((r) => setTimeout(r, ms));

for (const url of urls) {
  const html = await getHtml(url);
  await parse(html);
  await sleep(1000);
}
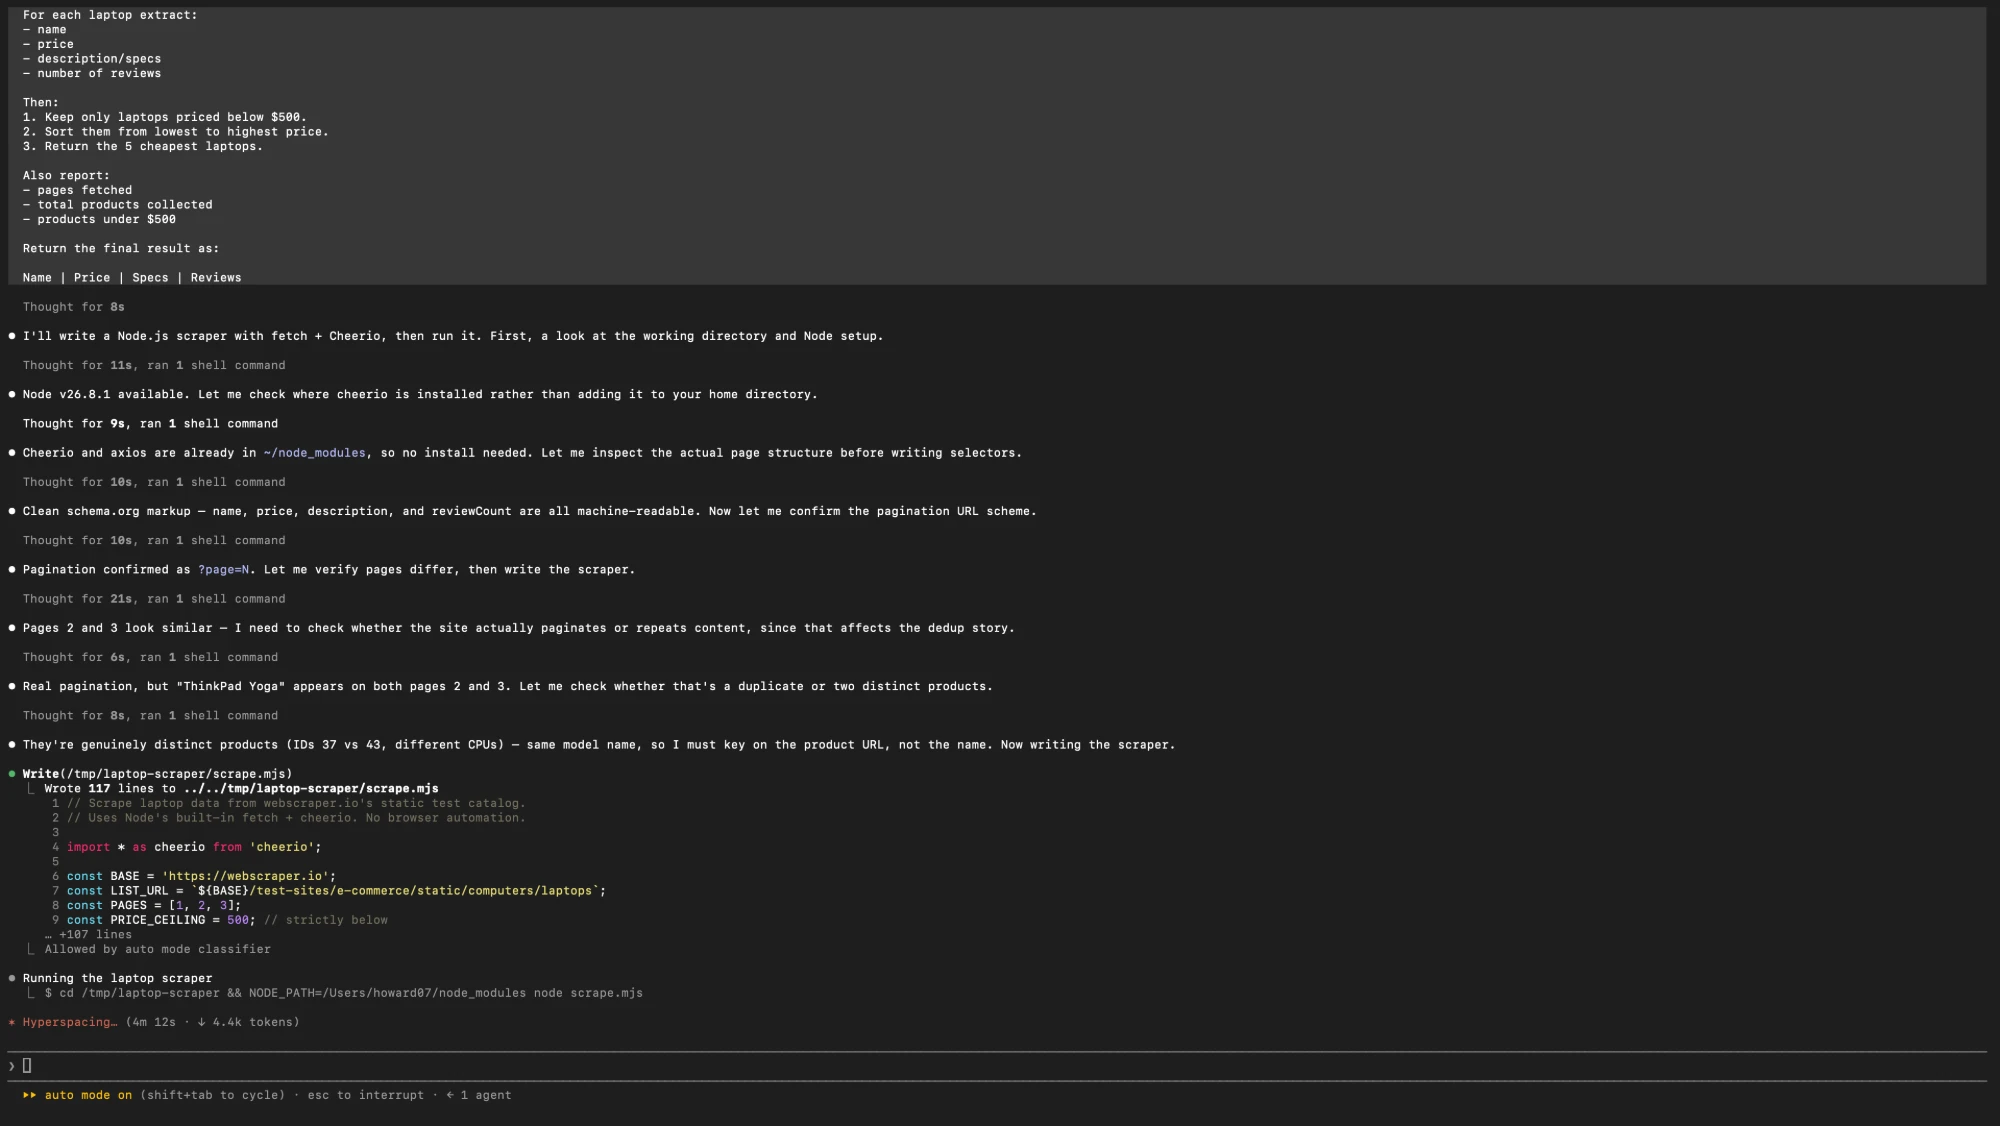
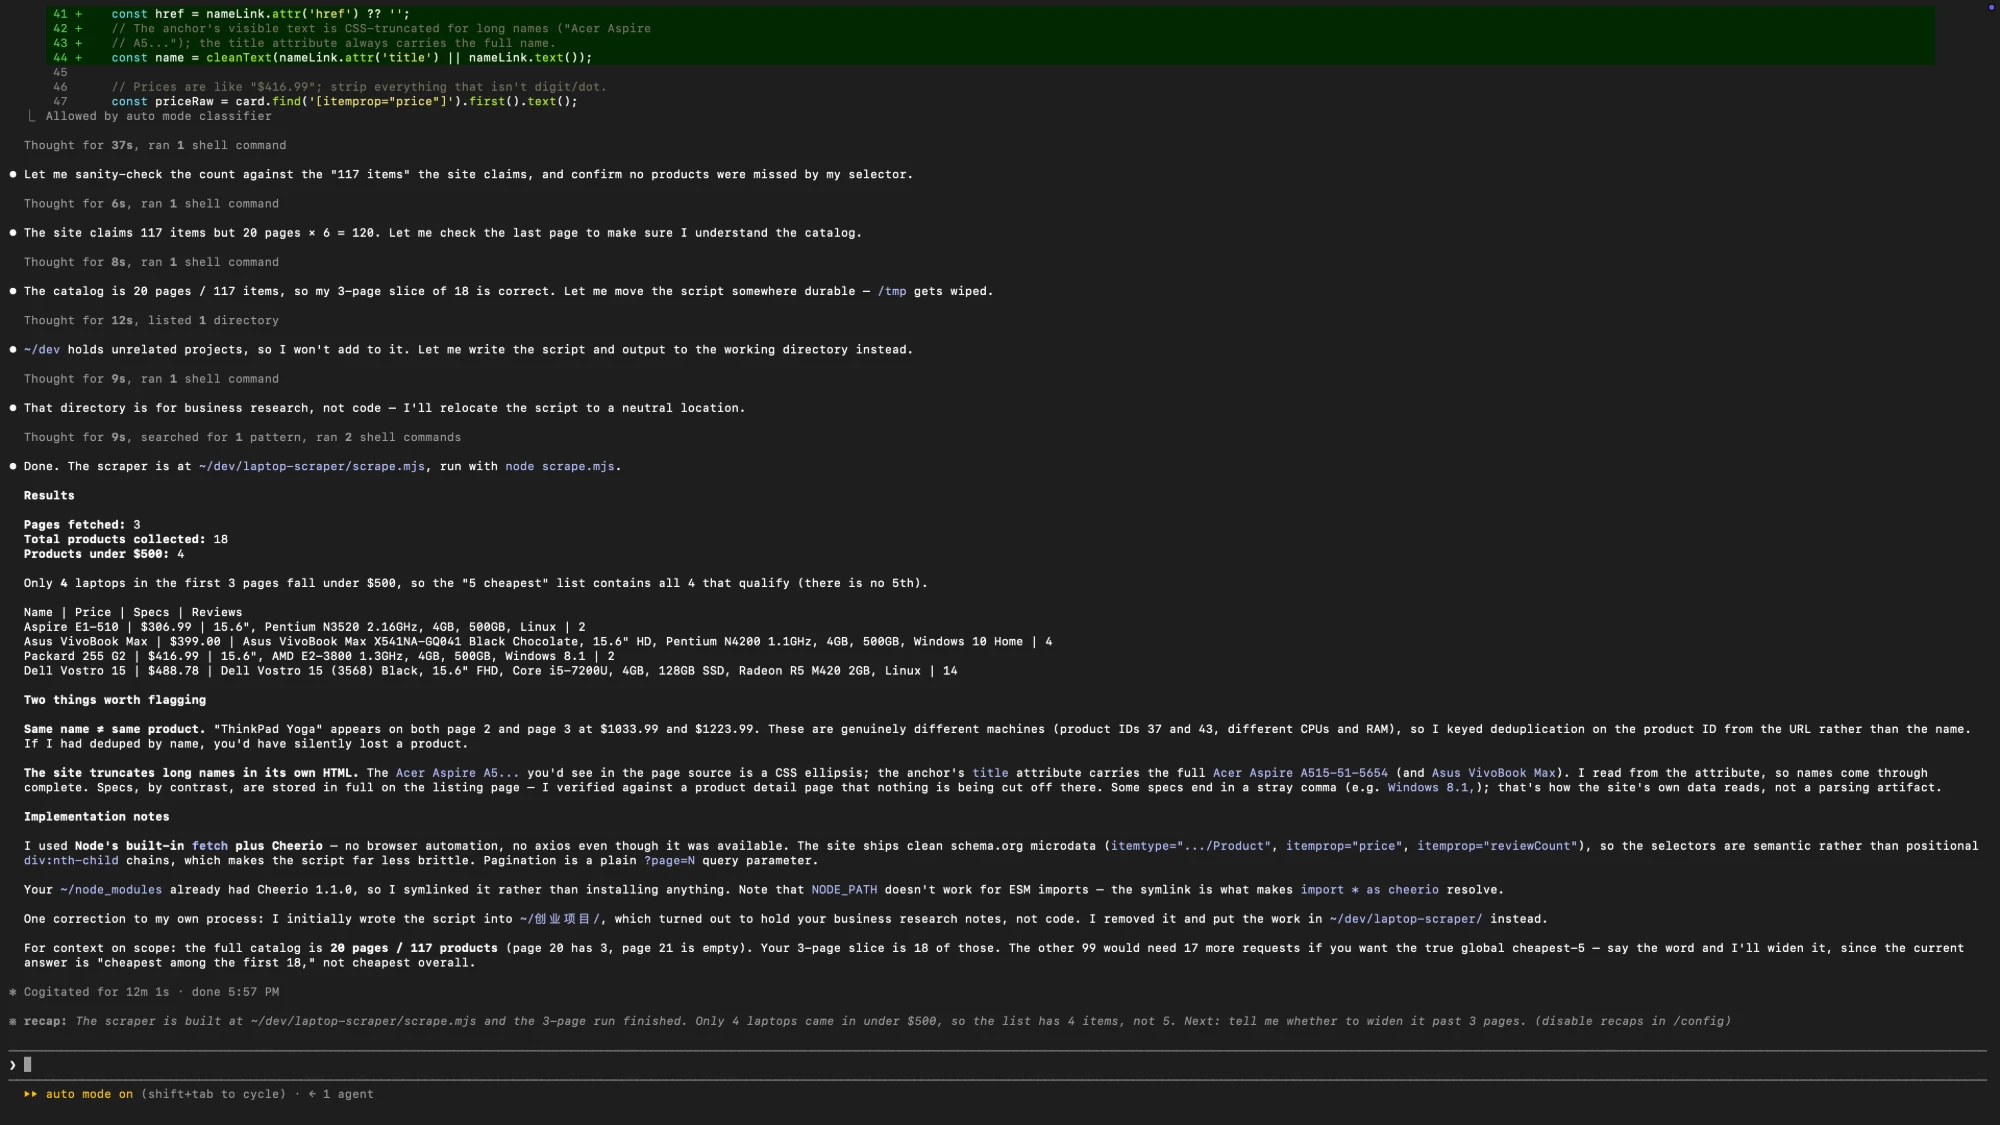
Ecco cosa restituisce davvero quel primo percorso. La tabella seguente è l'output reale di una semplice richiesta HTTP più una libreria di selettori su un catalogo di prova pubblico di portatili: nessun browser, nessuna fase di rendering, tre pagine recuperate come tre risposte statiche.
| ID | Nome | Prezzo | Specifiche | Recensioni |
|---|---|---|---|---|
| 32 | Aspire E1-510 | $306.99 | 15.6", Pentium N3520 2.16GHz, 4GB, 500GB, Linux | 2 |
| 45 | Asus VivoBook Max | $399 | 15.6" HD, Pentium N4200 1.1GHz, 4GB, 500GB, Windows 10 Home | 4 |
| 31 | Packard 255 G2 | $416.99 | 15.6", AMD E2-3800 1.3GHz, 4GB, 500GB, Windows 8.1 | 2 |
| 46 | Dell Vostro 15 | $488.78 | 15.6" FHD, Core i5-7200U, 4GB, 128GB SSD, Radeon R5 M420 2GB, Linux | 14 |
Quattro prodotti su diciotto costano meno di 500 $. Questo è l'intero risultato del primo percorso su questo catalogo: tre richieste, nessun rendering, nessun processo browser. Ed è anche qui che inizia la parte onesta, perché a questa tabella manca qualcosa che un lettore si aspetterebbe di vedere.
Cheerio, DOMParser o jsdom: quale parser scegliere?
Questi tre strumenti vengono confrontati come se fossero librerie intercambiabili. Non lo sono, perché promettono cose diverse: due analizzano il markup per consentirne l'interrogazione, uno implementa un DOM con esecuzione degli script.
Il parser su cui si basa questa guida è documentato su cheerio.js.org, dove è spiegato chiaramente che Cheerio analizza e interroga il markup anziché eseguire gli script della pagina.
| Opzione | Cosa può fare | Cosa non può fare |
|---|---|---|
| Cheerio | Analizza rapidamente una stringa HTML e la interroga con selettori in stile jQuery. Dipendenza ridotta, nessun browser, ideale per qualche centinaio di campi da un corpo di risposta. | Non esegue gli script della pagina, non renderizza componenti e non risolve il layout. Analizza il markup; non si comporta come un browser. |
| jsdom | Fornisce un'implementazione del DOM in Node.js con document, window ed esecuzione degli script, così il codice scritto per le API del browser funziona senza modifiche. | Non eguaglia un browser reale in rendering o fedeltà ed è molto più pesante per pagina. È un sostituto del DOM, non Chrome. |
| DOMParser | Trasforma una stringa in un documento interrogabile usando un'API del browser integrata, senza aggiungere alcuna dipendenza al progetto. | Non si può attendere: è sincrono e bloccante e in Node.js è diventato un globale solo nelle versioni recenti. |
La lettura da Cheerio usa la familiare API dei selettori. Nota che il testo estratto viene ripulito agli estremi, perché il markup ottenuto dallo scraping contiene indentazione e ritorni a capo che altrimenti finirebbero nel tuo dataset:
import * as cheerio from "cheerio";

const $ = cheerio.load(html);
const items = $(".product-card").map((i, el) => ({
  name: $(el).find(".name").text().trim(),
  price: $(el).find(".price").text().trim(),
})).get();
La stessa estrazione con DOMParser si presenta così e funziona solo dove quel globale esiste:
const doc = new DOMParser().parseFromString(html, "text/html");
const rows = [...doc.querySelectorAll("table tbody tr")].map((tr) => ({
  cells: [...tr.querySelectorAll("td")].map((td) => td.textContent.trim()),
}));
Come si trova l'endpoint JSON che la pagina già utilizza?
Prima di scrivere anche un solo selettore, apri il pannello di rete del browser, filtra per fetch e XHR, ricarica la pagina e guarda cosa è tornato indietro. Molti siti basati sui dati compongono la pagina visibile a partire da un piccolo numero di risposte JSON, molto più facili da usare del markup.
Quando ne trovi uno, la richiesta di solito richiede gli stessi header inviati dalla pagina e a volte un cookie di sessione. Riproducila con l'output copy-as-fetch del pannello di rete invece di ricostruirla a mano.
const res = await fetch("https://example.com/api/listings?page=1", {
  headers: { accept: "application/json" },
});

if (!res.ok) throw new Error(`${res.status} for listings page 1`);

const { items } = await res.json();Perché una pagina renderizzata lato client restituisce un guscio vuoto?
Una pagina renderizzata lato client invia un markup che non contiene quasi nulla. La risposta iniziale contiene un elemento root, un bundle di script e forse uno stato di caricamento. Il testo che una persona vede sullo schermo viene creato da JavaScript dopo l'arrivo della risposta, quindi una richiesta HTTP che si limita a leggere la risposta non ha nulla da leggere.
È un problema diagnosticabile, non misterioso. Due controlli individuano la maggior parte dei casi: il testo visibile nella risposta è una piccola frazione di quello mostrato dal browser e il markup è dominato dai tag script:
const text = html.replace(/<script[\s\S]*?<\/script>/g, "").replace(/<[^>]+>/g, " ").replace(/\s+/g, " ").trim();

console.log({
  textLength: text.length,
  scriptCount: (html.match(/<script\b/g) ?? []).length,
  hasRoot: /id="(root|app|__next)"/.test(html),
});
Testo breve, molti script e un div root vuoto insieme significano che il terzo percorso è la risposta onesta. Poche decine di caratteri di testo senza alcun tag script di solito indicano qualcosa di più semplice: la richiesta è stata bloccata oppure hai chiesto l'URL sbagliato.
Come si presenta la differenza nella pratica:
| Segnale nella risposta HTTP | Cosa significa di solito | Passo successivo |
|---|---|---|
| Contenuto completo, markup reale | È stato il server a renderizzare la pagina. Non serve altro. | Analizzala con una libreria di selettori. |
| Div root e molti script | Rendering lato client. Il contenuto arriva dopo la risposta. | Cerca l'endpoint JSON oppure renderizza la pagina. |
| Testo molto breve, nessuno script | Bloccata, reindirizzata o URL del tutto sbagliato. | Registra stato, URL finale e header prima di analizzare. |
Come fa Playwright a fare scraping su una pagina in un browser reale?
Playwright guida un browser reale, quindi la pagina viene eseguita esattamente come per un visitatore. La struttura dello scraping è più snella di quanto molti si aspettino: apri un contesto, vai all'URL, attendi l'elemento specifico che ti serve e poi leggilo.
La superficie API usata qui è documentata su playwright.dev, il riferimento canonico per avviare browser, contesti e locator.
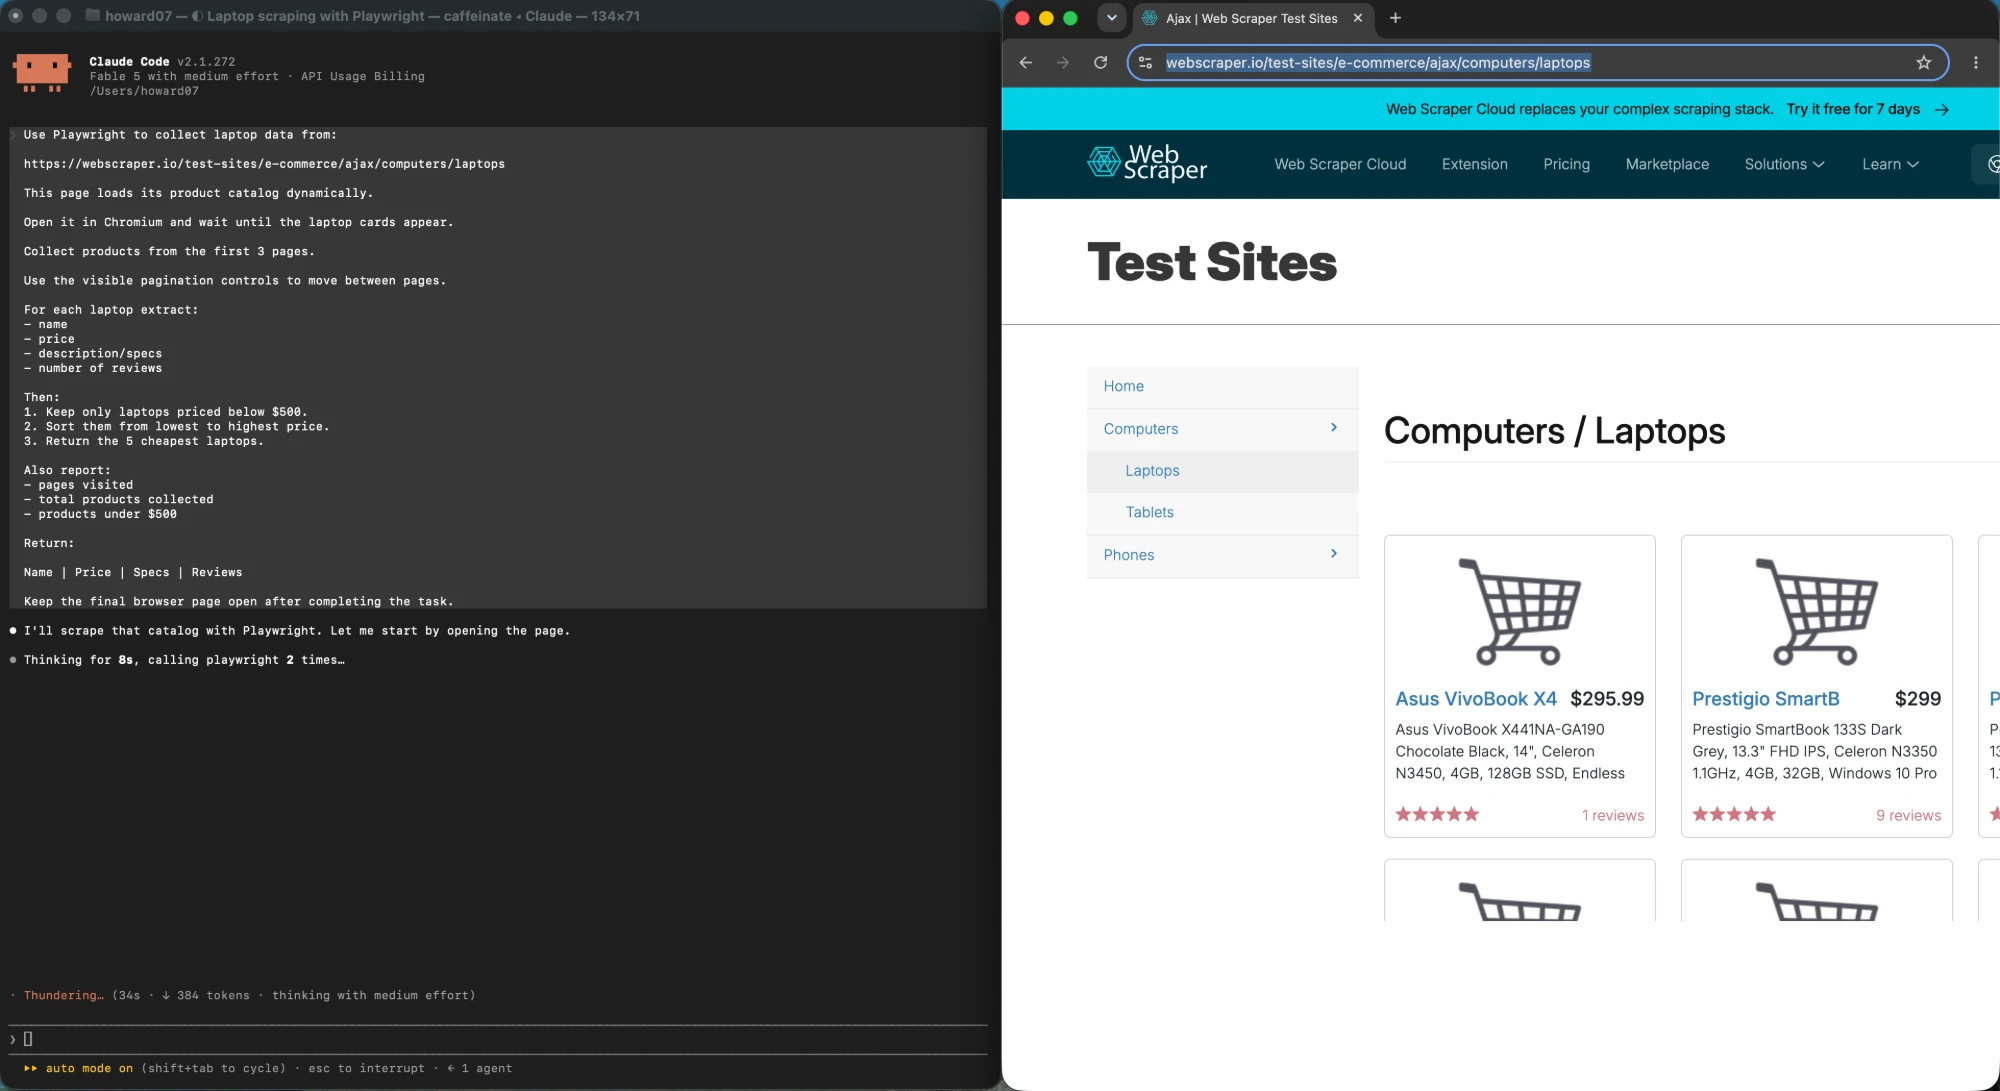
Lo schema di recupero seguente attende un selettore e poi estrae tramite page.evaluate, che esegue la tua funzione all'interno della pagina e restituisce un risultato serializzabile:
import { chromium } from "playwright";

const browser = await chromium.launch();
const context = await browser.newContext();

try {
  const page = await context.newPage();
  await page.goto(url, { waitUntil: "domcontentloaded" });
  await page.waitForSelector(".product-card");

  const rows = await page.evaluate(() =>
    [...document.querySelectorAll(".product-card")].map((el) => ({
      name: el.querySelector(".name")?.textContent?.trim() ?? null,
      price: el.querySelector(".price")?.textContent?.trim() ?? null,
    })),
  );

  console.log(rows);
} finally {
  // contexts hold the memory; close it even when the scrape throws
  await context.close();
  await browser.close();
}
Due dettagli del ciclo di vita contano più dei selettori. Il contesto è l'unità economica usa e getta, quindi un solo browser può servire più esecuzioni isolate e ognuna si chiude con una close. Il secondo è che l'estrazione del testo nella pagina restituisce nodi di testo, non valori renderizzati: il contenuto nascosto via CSS è comunque nel DOM e comparirà ugualmente nel tuo output.
Quando l'obiettivo è un elemento specifico invece dell'intera lista, i locator sono il percorso di recupero più pulito. La documentazione di Playwright sui locator osserva che attendere un clic non è necessario per pulsanti, link e campi di input; vale la pena ricordarlo prima di avvolgere ogni interazione in un'attesa esplicita:
const title = await page.getByRole("heading", { level: 1 }).innerText();
const price = await page.locator("[data-testid=price]").innerText();
Come cambiano il piano sessioni, rischio di blocco e CAPTCHA?
Nel momento in cui un obiettivo richiede il login, lo scraper smette di essere un esercizio sui dati e diventa un problema di gestione delle sessioni. Playwright lo supporta direttamente: autenticati una volta, salva lo storage state del browser in un file e riutilizzalo nelle esecuzioni successive invece di programmare l'inserimento delle credenziali ogni volta.
// once, interactively
await context.storageState({ path: "auth.json" });

// later runs
const context = await browser.newContext({ storageState: "auth.json" });
Da ciò derivano due fatti operativi. Lo stato di sessione salvato è una credenziale, quindi va in un archivio di segreti e non nel repository. E una sessione salvata scade, perciò un'esecuzione che all'improvviso inizia a restituire pagine di login è un problema di sessione, non di selettori.
Tenere vivo quello stato tra un avvio e l'altro è un argomento a sé: sessioni browser persistenti tra esecuzioni di agenti vengono trattate in dettaglio.
Per il traffico automatizzato in generale, tre vincoli decidono se hai un lavoro di scraping o una battaglia persa: cosa consentono le direttive robots e i termini del sito, quale frequenza il sito pubblica o tollera e se la risposta che ricevi è il contenuto oppure una pagina di verifica. Sono questioni di policy da risolvere prima di scrivere codice, trattate più in dettaglio nella nostra guida su scraping dietro i muri di login.
Che cosa fa fallire uno scraper JavaScript in produzione?
Gli scraper raramente falliscono perché un selettore era sbagliato. Falliscono alla seconda esecuzione, al centesimo URL, quando una pagina è più lenta, una risposta è un reindirizzamento o il sito inizia a limitare le richieste. Le correzioni sono poco appariscenti e molto specifiche.
async function getWithRetry(url, attempt = 0) {
  const res = await fetch(url);
  if (res.status === 429 || res.status >= 500) {
    if (attempt >= 3) throw new Error(`giving up on ${url}`);
    const retryAfter = Number(res.headers.get("retry-after"));
    const waitMs = Number.isFinite(retryAfter)
      ? retryAfter * 1000
      : 2 ** attempt * 1000;
    await new Promise((r) => setTimeout(r, waitMs));
    return getWithRetry(url, attempt + 1);
  }
  if (!res.ok) throw new Error(`${res.status} for ${url}`);
  return res.text();
}
La concorrenza è la seconda trappola. Dieci contesti browser in parallelo su una sola macchina competono in gran parte per la stessa CPU, quindi il guadagno di throughput è inferiore al costo in memoria e il sito vede una raffica anziché un flusso costante. Parti in sequenza, misura e solo allora aumenta il numero se l'obiettivo lo tollera.
La terza è che qualsiasi scraper che legge un endpoint non garantito ha bisogno di un fallback. Mantieni nel codice l'analisi basata sui selettori della pagina visibile e lascia che una chiamata JSON fallita ricada su di essa, così un cambiamento silenzioso a monte degrada l'esecuzione invece di svuotarla.
Quando serve davvero un browser reale?
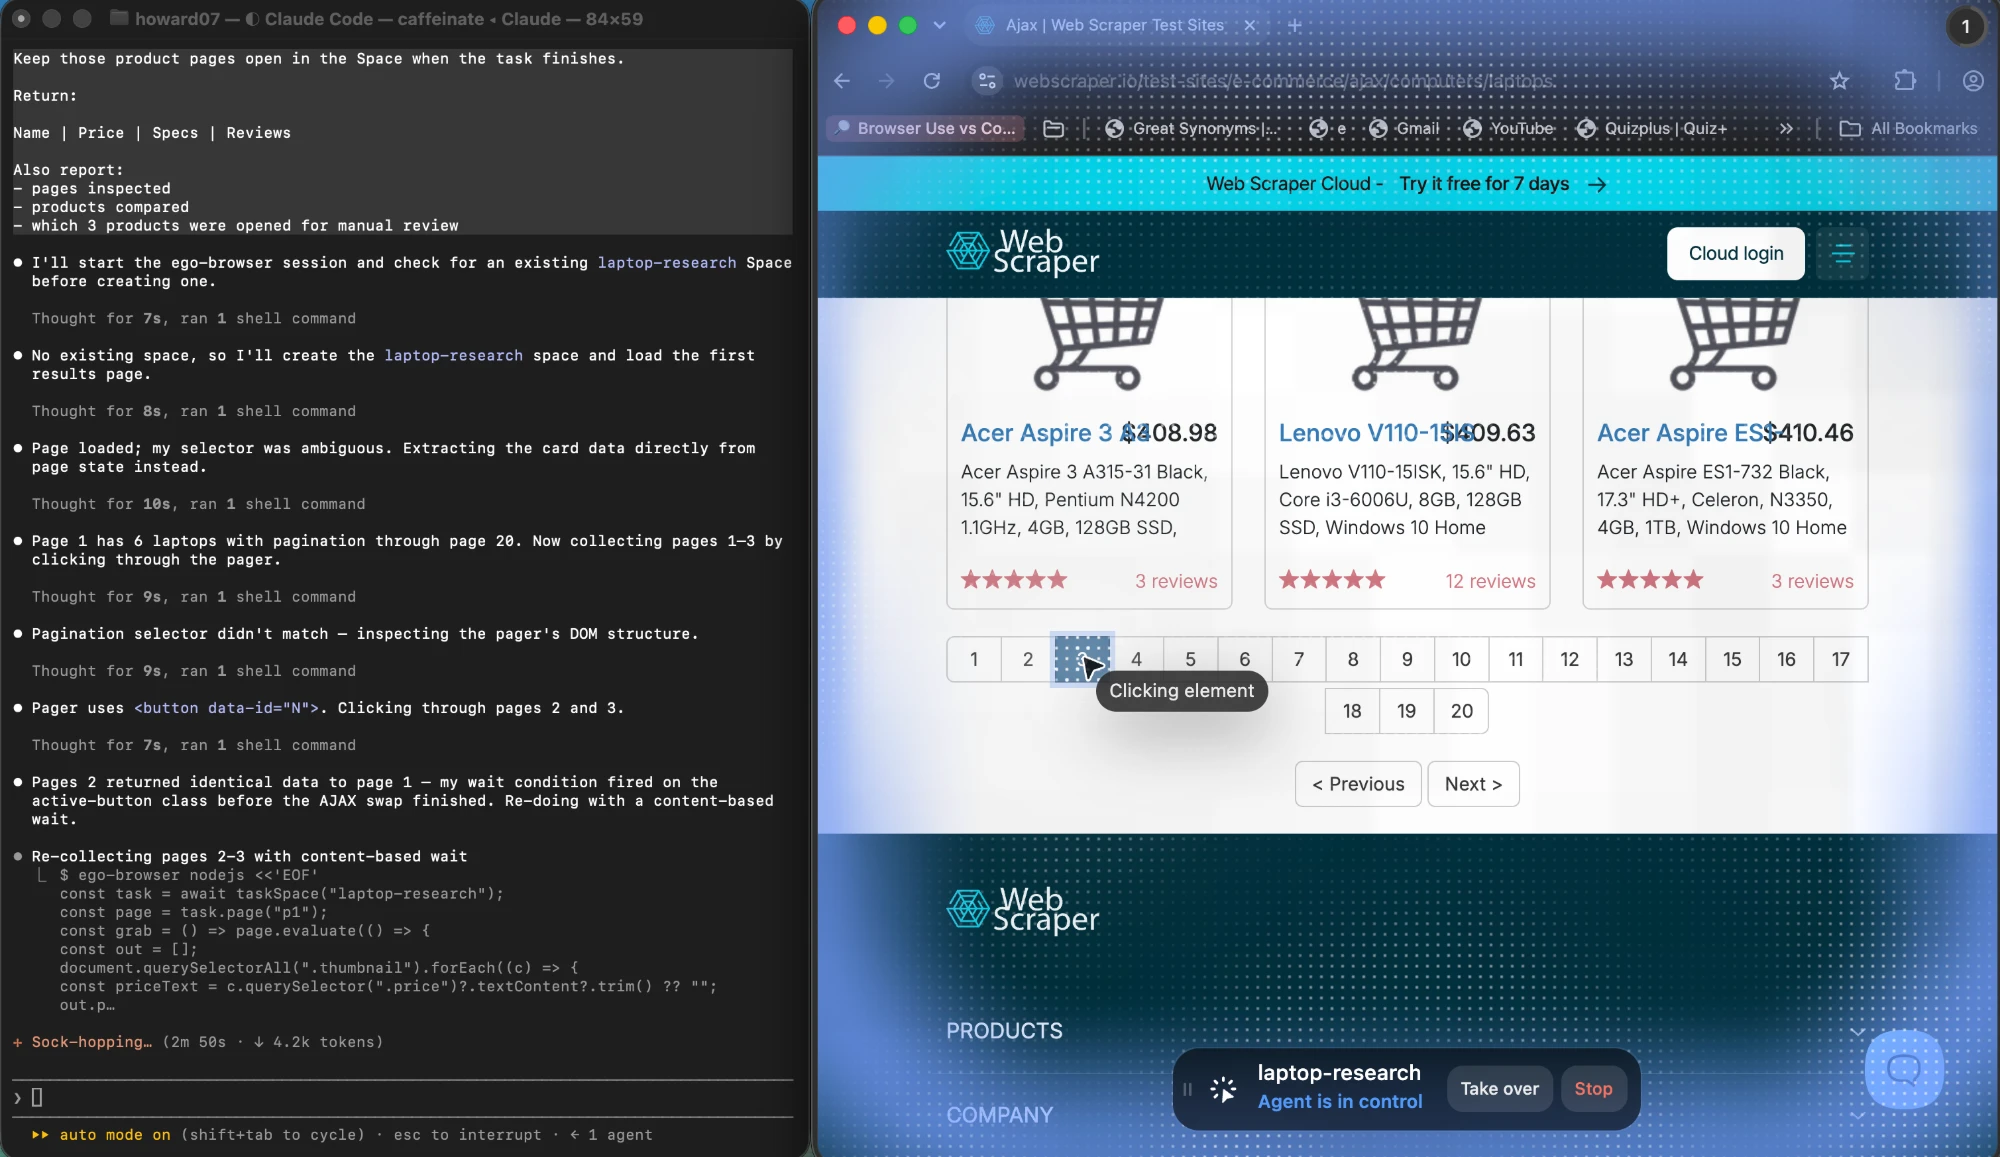
Un browser reale è la risposta giusta quando il compito richiede qualcosa che solo un browser può fornire: una sessione autenticata già presente sulla tua macchina, contenuto che compare solo dopo un'interazione, un flusso in cui una persona deve intervenire a metà strada o un risultato che va osservato mentre accade anziché recuperato. Al di fuori di questi casi, l'HTTP con un parser è più veloce, più economico e più facile da mantenere in funzione.
Il compromesso tra un browser headless e un browser reale è trattato in browser headless vs browser reale per gli agenti AI.
È la situazione in cui vale la pena introdurre un agente browser guidato da un obiettivo. ego (lite) è un browser pensato per il lavoro guidato da agenti: descrivi l'obiettivo e lui opera in un browser reale, comprese le sessioni di login che hai già aperte, con un'interfaccia visibile che puoi riprendere in mano quando un passaggio richiede il giudizio umano. Per le attività di scraping che richiedono uno stato di login reale, una pagina dinamica, un'esecuzione visibile o un passaggio a una persona, questo elimina il lavoro di configurazione delle sessioni descritto sopra. Non è un sostituto di Playwright e non promette nulla su ogni sito: le pagine che rispondono con una verifica o che vietano l'accesso automatizzato sono fuori portata per lui esattamente come per qualsiasi altro percorso. Dove una semplice richiesta HTTP o un'API ufficiale restituiscono già ciò che ti serve, aggiungere un agente browser non farebbe che rallentare il lavoro.
Per un confronto più approfondito sugli strumenti del browser, quando il browser è davvero la risposta, il nostro confronto dello scraping tra Playwright e Puppeteer copre la scelta della libreria in sé, e flussi di lavoro degli scraper web basati sull'AI spiega dove si inseriscono gli agenti in una pipeline di scraping.
Quali sono le principali sfide e i limiti?
Ogni percorso di questo schema ha una modalità di guasto che non puoi eliminare con l'ingegneria, e conoscerle in anticipo è ciò che distingue uno scraper che funziona per un anno da uno che funziona per una settimana.
L'analisi statica si rompe quando il sito ridisegna il markup. Non ha modo di accorgersene, quindi un campo che diventa silenziosamente null è più comune di un crash conclamato. Convalida un campione a ogni esecuzione invece di fidarti della pipeline.
Gli endpoint JSON interni si rompono senza alcun preavviso e sono la parte meno contrattuale di qualsiasi sito. Un'esecuzione riuscita oggi non è una prova per il mese prossimo.
L'automazione del browser è la più realistica e la più fragile su larga scala. La memoria cresce con la concorrenza, le sessioni scadono e i sistemi anti-bot reagiscono a pattern anziché alle intenzioni, quindi una tecnica che funziona da un portatile può non funzionare da un datacenter.
E il limite più grande non è tecnico. Cosa ti è consentito raccogliere, con quale frequenza e cosa puoi farne dopo lo decidono i termini del sito, le direttive robots e la legge della tua giurisdizione, e nulla di tutto ciò cambia perché il codice funziona.
La sequenza di risoluzione dei problemi che ne deriva è breve. Quando uno scraping non restituisce nulla, controlla prima il codice di stato, poi se il contenuto è presente nella risposta e infine se il selettore corrisponde al DOM renderizzato anziché al sorgente. Solo dopo questi tre passaggi si dovrebbe prendere in considerazione il browser.
FAQ
Serve una libreria per effettuare richieste HTTP in Node.js?
No. Node.js espone l'API Fetch come globale, quindi fetch è disponibile senza installare nulla, insieme all'oggetto response e ai suoi membri ok, status e text(). Quello che serve davvero è un parser, perché fetch restituisce una stringa e la corrispondenza tra stringhe sull'HTML si rompe non appena il markup cambia.
Perché il mio scraper restituisce una lista vuota da una pagina che nel browser sembra a posto?
La causa più probabile è che la pagina sia renderizzata lato client e che i dati non siano mai stati nella risposta HTTP. Verificalo confrontando il testo visibile nella risposta grezza con quello mostrato dal browser e contando i tag script rispetto al contenuto. Se la risposta è un guscio, passa all'endpoint JSON del sito oppure renderizza la pagina in un browser reale.
Cheerio sostituisce un browser headless?
No. Cheerio analizza l'HTML e ti permette di interrogarlo con i selettori. Non esegue JavaScript, quindi non può produrre il contenuto che la pagina genera dopo il caricamento. È lo strumento giusto per il primo percorso e quello sbagliato per il terzo, e ricorrere a un browser quando basterebbe Cheerio è il costo inutile più comune nel codice di scraping.
Come faccio a sapere se una pagina è renderizzata lato server o lato client?
Richiedi l'URL e guarda la risposta grezza invece del DOM renderizzato. Se i valori che cerchi sono presenti nel corpo della risposta, la pagina è renderizzata lato server e il percorso economico funziona. Se il corpo contiene un elemento root, bundle di script e poco testo, il contenuto viene assemblato nel browser.
Come faccio a fare scraping su una pagina che richiede il login?
Accedi una volta in un contesto browser, salva lo storage state in un file e carica quello stato nelle esecuzioni successive. Tratta il file come un segreto, aspettati che scada e preferisci una sessione che sei autorizzato a usare. Se un obiettivo richiede di aggirare un CAPTCHA o una verifica di proprietà, fermati e usa invece un percorso ufficiale.
Playwright o Puppeteer: quale è meglio per lo scraping?
Entrambi guidano un browser reale e possono fare scraping sulle stesse pagine. La decisione riguarda dettagli della libreria come il supporto ai locator, il comportamento di attesa e i binding per i linguaggi, non i percorsi di accesso, ed è trattata nel nostro confronto tra Playwright e Puppeteer. Qualunque tu scelga, la decisione sul percorso di questo articolo viene prima.
Quante pagine posso fare scraping contemporaneamente?
Parti in sequenza e misura prima di aumentare la concorrenza. Le richieste HTTP scalano a un costo molto inferiore rispetto ai contesti browser, e browser in parallelo su una sola macchina competono in gran parte per la stessa CPU mentre sottopongono il sito di destinazione a una raffica di traffico. Per lo scraping via HTTP, quattro-otto richieste in volo con una pausa sono un punto di partenza più sicuro di qualche decina.
Cosa devo fare quando ricevo una risposta 429?
Leggi l'header Retry-After e attendi almeno quel tempo, poi riprova con backoff esponenziale fino a un limite ridotto e fallisci in modo evidente dopo. Un 429 è un segnale di frequenza, non un errore da martellare in un ciclo di tentativi serrato, e ignorarlo è il modo in cui un indirizzo finisce in una lista di blocco.
Lo scraping è legale?
Dipende dal sito, dai dati, dalla giurisdizione e da cosa fai con il risultato. Le direttive robots e i termini di servizio indicano ciò che un sito permette, e le norme sui dati personali e sui diritti sui database variano da paese a paese. Nulla in questo articolo costituisce consulenza legale; verifica i termini e la legge applicabile prima di raccogliere qualsiasi cosa su larga scala.
Quando conviene usare un'API ufficiale invece dello scraping?
Ogni volta che ne esiste una e copre i campi che ti servono. Un'API documentata è un contratto stabile, di solito ha limiti di frequenza espliciti e non si rompe quando cambia il layout della pagina. Lo scraping è il ripiego per i dati pubblicati in un browser senza un percorso di accesso supportato, non la scelta predefinita.
Serve un agente browser per fare scraping?
Solo per attività che richiedono uno stato di login reale, contenuto che compare dopo un'interazione, un'esecuzione visibile o un intervento umano a metà flusso. Per le pagine che restituiscono il contenuto via HTTP o per i siti con un'API ufficiale, un agente browser aggiunge costo senza aggiungere capacità.
Se vuoi provare il percorso con l'agente browser su un'attività di scraping che ne ha davvero bisogno, ego (lite) è scaricabile gratuitamente, e le pagine scraper di prezzi e scraper SERP illustrano due lavori concreti dall'inizio alla fine.