
El web scraping con JavaScript a menudo falla no porque el código esté mal, sino porque se eligió la ruta de acceso equivocada. Si los datos ya están en el HTML inicial, basta con fetch de Node.js más un parser de HTML. El navegador solo se vuelve necesario cuando la página debe ejecutar JavaScript, paginar, hacer clic o interactuar de algún modo antes de que aparezcan los datos, que es la línea divisoria entre el HTML estático y las páginas renderizadas.
Playwright encaja muy bien en flujos que se conocen de antemano y se repiten a menudo: abrir la página, esperar un elemento, hacer clic en un control, extraer los campos y recorrer otra vez el mismo camino. El problema empieza cuando cambian la estructura de la página, la paginación o el flujo de interacción y una secuencia fija de selectores y acciones comienza a fallar.
Ahí es donde encaja mejor un navegador dirigido por agentes como ego (lite). En lugar de dar por hecho que el camino original sigue existiendo, el agente puede inspeccionar la página renderizada actual, decidir qué hacer a continuación y seguir ejecutando de forma fiable tras una navegación o un cambio dinámico.
¿Qué determina en realidad si un scraper de JavaScript funciona?
La ruta de acceso decide el resultado. Un mismo sitio objetivo puede ser trivialmente rastreable por HTTP y completamente opaco a HTTP, según si los datos llegan en la respuesta HTML inicial o si JavaScript, al ejecutarse en un navegador, los obtiene y los pinta después.
Así que la primera tarea no es escribir un scraper. Es abrir la página objetivo, ver el código fuente en lugar del DOM renderizado y averiguar dónde viven realmente los valores que quiere. Todo lo demás en esta guía se deriva de esa respuesta.
¿Cuál de las tres rutas de acceso necesita su objetivo?
Tres rutas cubren casi cualquier trabajo de scraping y están ordenadas por coste. El HTML estático es lo más barato y rápido. Un endpoint JSON que la página ya invoca suele ser el dato más limpio que obtendrá. Un navegador real es lo más capaz y lo más caro en CPU, memoria y fragilidad.
| Ruta | Lo que puede hacer | Lo que no puede hacer |
|---|---|---|
| Solicitud HTTP + parser de HTML | Obtiene cualquier URL directamente, lee el cuerpo de la respuesta y consulta el marcado devuelto. Procesa miles de páginas por minuto y por proceso y no necesita ningún binario de navegador. | No ejecuta los scripts de la página, ni hace clic, ni se desplaza, ni rellena formularios. En una página renderizada en el cliente devuelve el cascarón vacío, porque los datos nunca estuvieron en la respuesta. |
| Endpoint JSON directo | Devuelve datos estructurados sin analizar marcado, así que los nombres de los campos sobreviven a rediseños del diseño de la página. La carga útil más pequeña y el análisis más rápido. | No se mantiene estable cuando el sitio se actualiza. Estos endpoints son internos, no están documentados y pueden cambiar o empezar a rechazar solicitudes sin aviso. |
| Automatización con un navegador real | Ejecuta el JavaScript de la página, espera a que aparezca el contenido e interactúa con el resultado renderizado exactamente como lo haría una persona. | No escala de forma barata. Cada contexto de navegador consume memoria real, y una flota de ellos necesita más infraestructura que un bucle HTTP. |
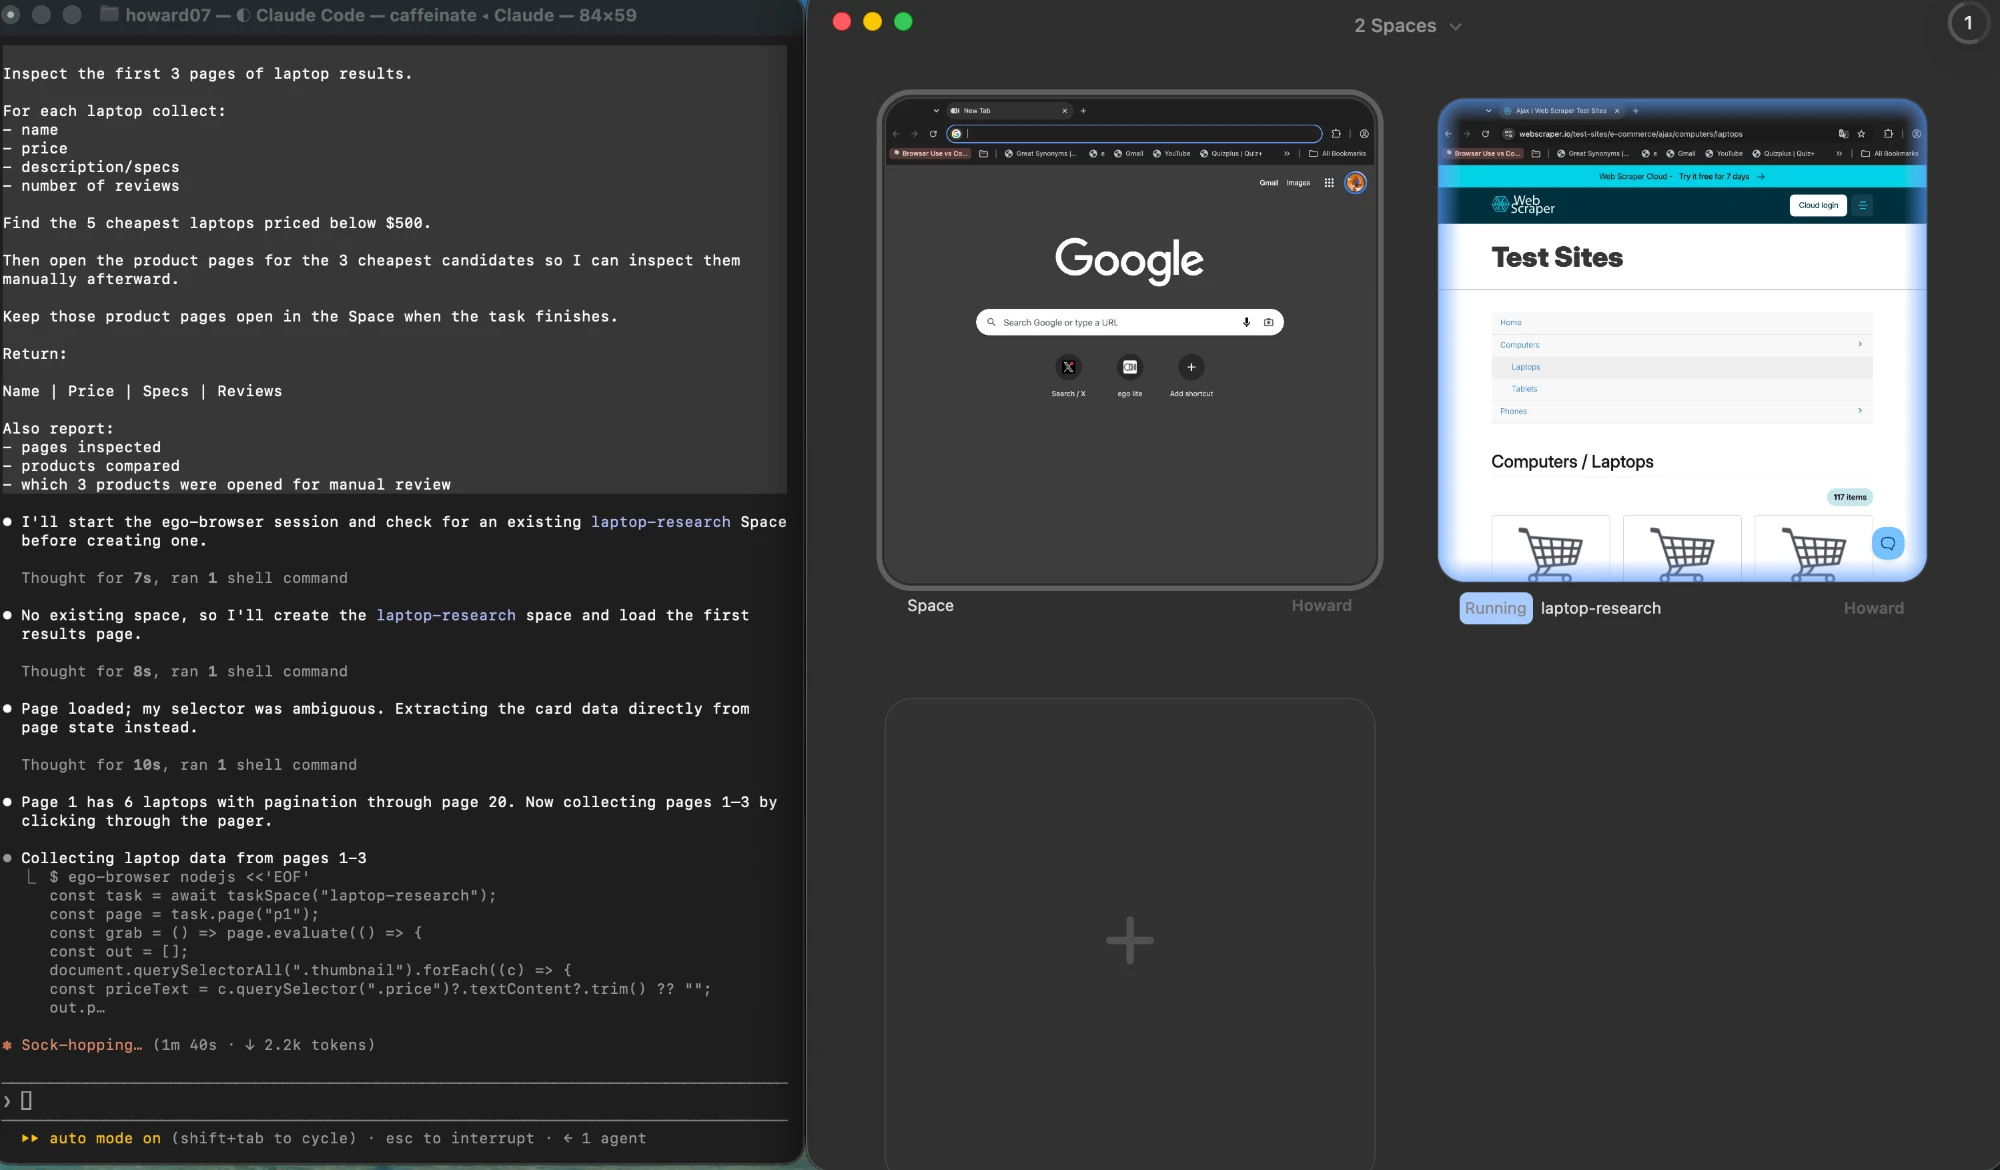
¿Cómo se obtiene y analiza HTML estático en Node.js?
Empiece por la plataforma. Node.js expone la Fetch API como global, así que una solicitud no necesita ninguna dependencia. El patrón siguiente es toda la primera ruta: solicitar, comprobar el estado, leer el texto y entregar el marcado a un parser.
La solicitud en sí no necesita nada más allá de la plataforma, porque la Fetch API viene incluida como global de Node.js, así que un GET simple no tiene ninguna biblioteca HTTP que instalar.
La comprobación del estado es la parte que la gente quita primero y la que más echa de menos. Una página 404 o de bloqueo de bots también devuelve un cuerpo, y ese cuerpo se analiza sin problemas en cero elementos coincidentes, lo que se parece exactamente a un error de selector.
const res = await fetch(url, {
  headers: { "user-agent": "my-scraper/1.0 (+contact@example.com)" },
});

if (!res.ok) {
  throw new Error(`${res.status} ${res.statusText} for ${url}`);
}

const html = await res.text();
La limitación de frecuencia va en el mismo bucle, no añadida después. Una espera con await entre solicitudes mantiene cortés un trabajo pequeño y mantiene su dirección fuera de una lista de bloqueo:
const sleep = (ms) => new Promise((r) => setTimeout(r, ms));

for (const url of urls) {
  const html = await getHtml(url);
  await parse(html);
  await sleep(1000);
}
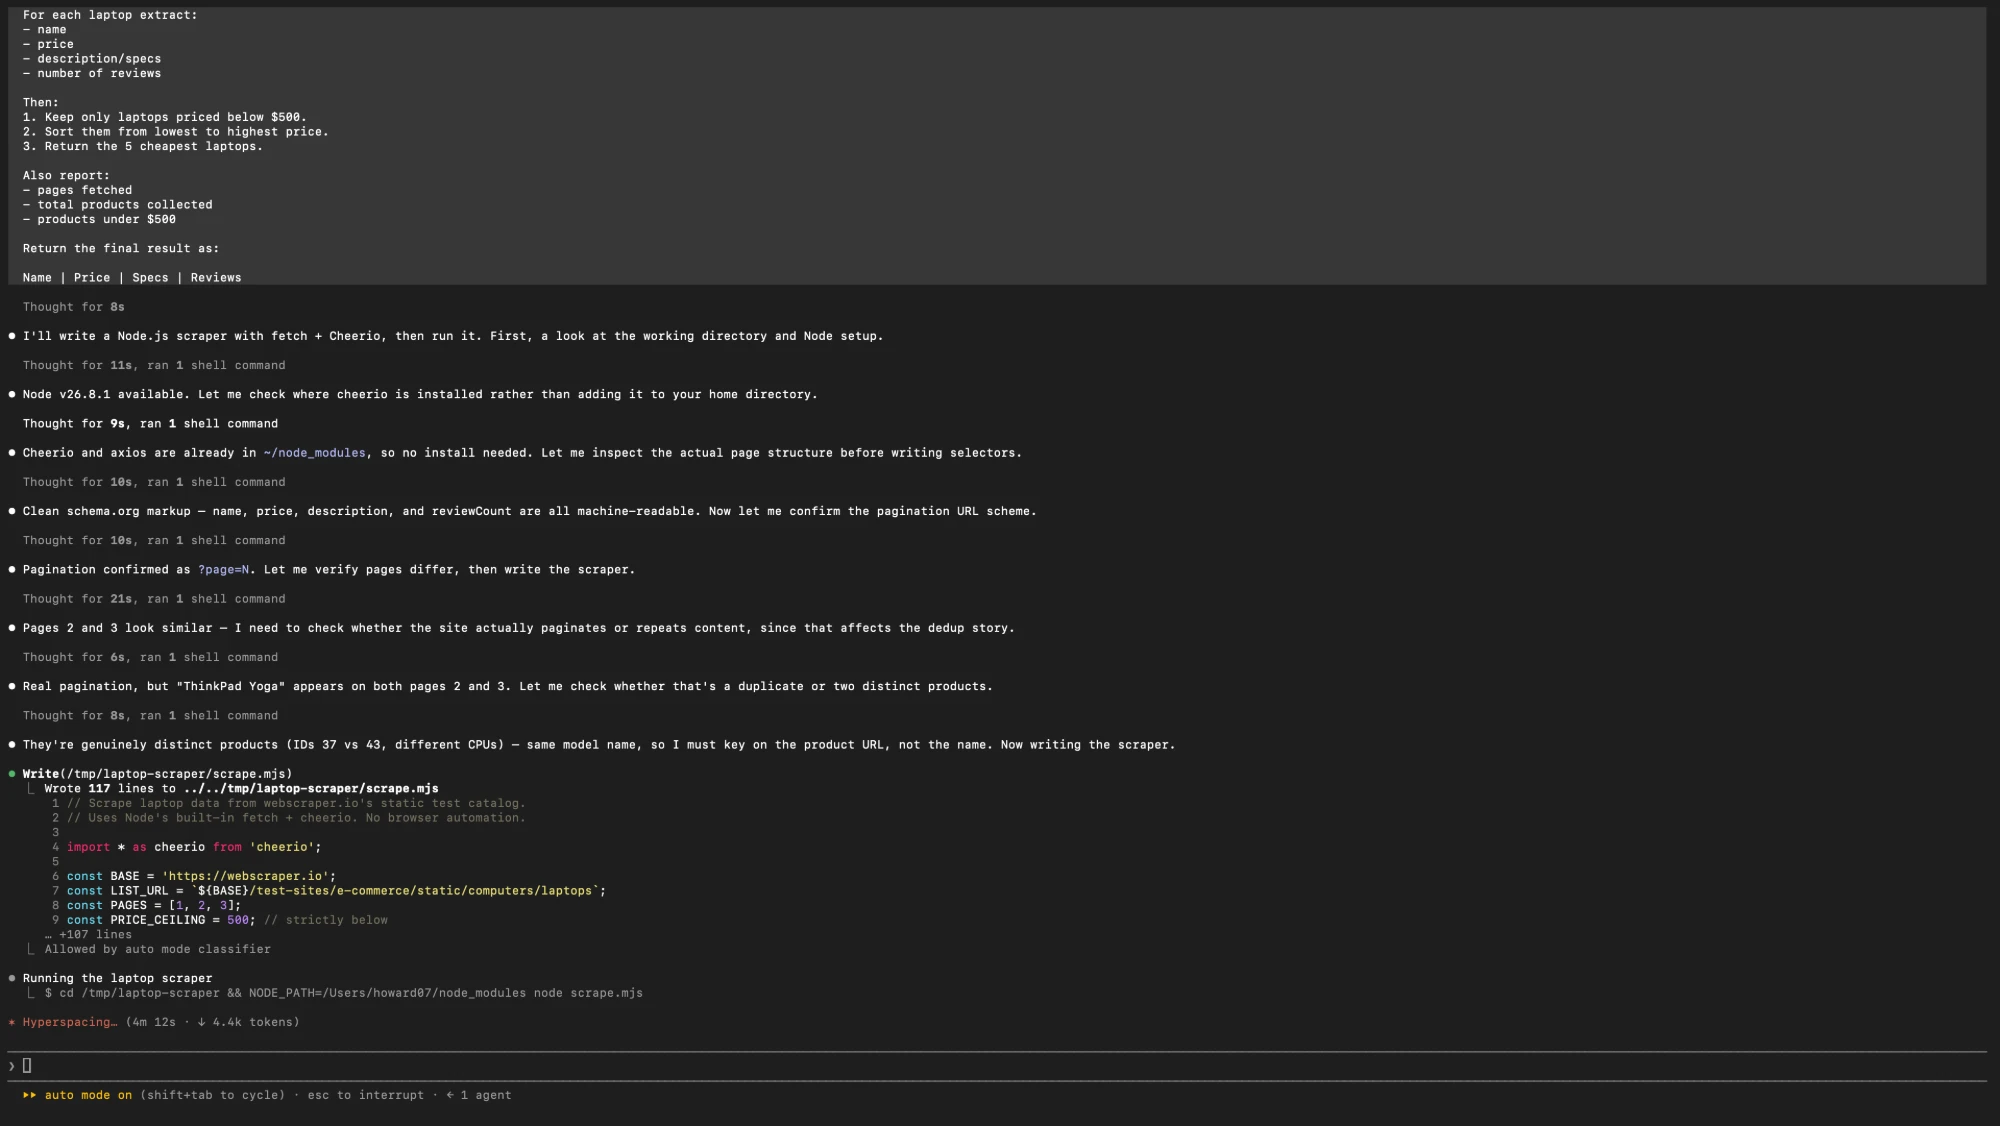
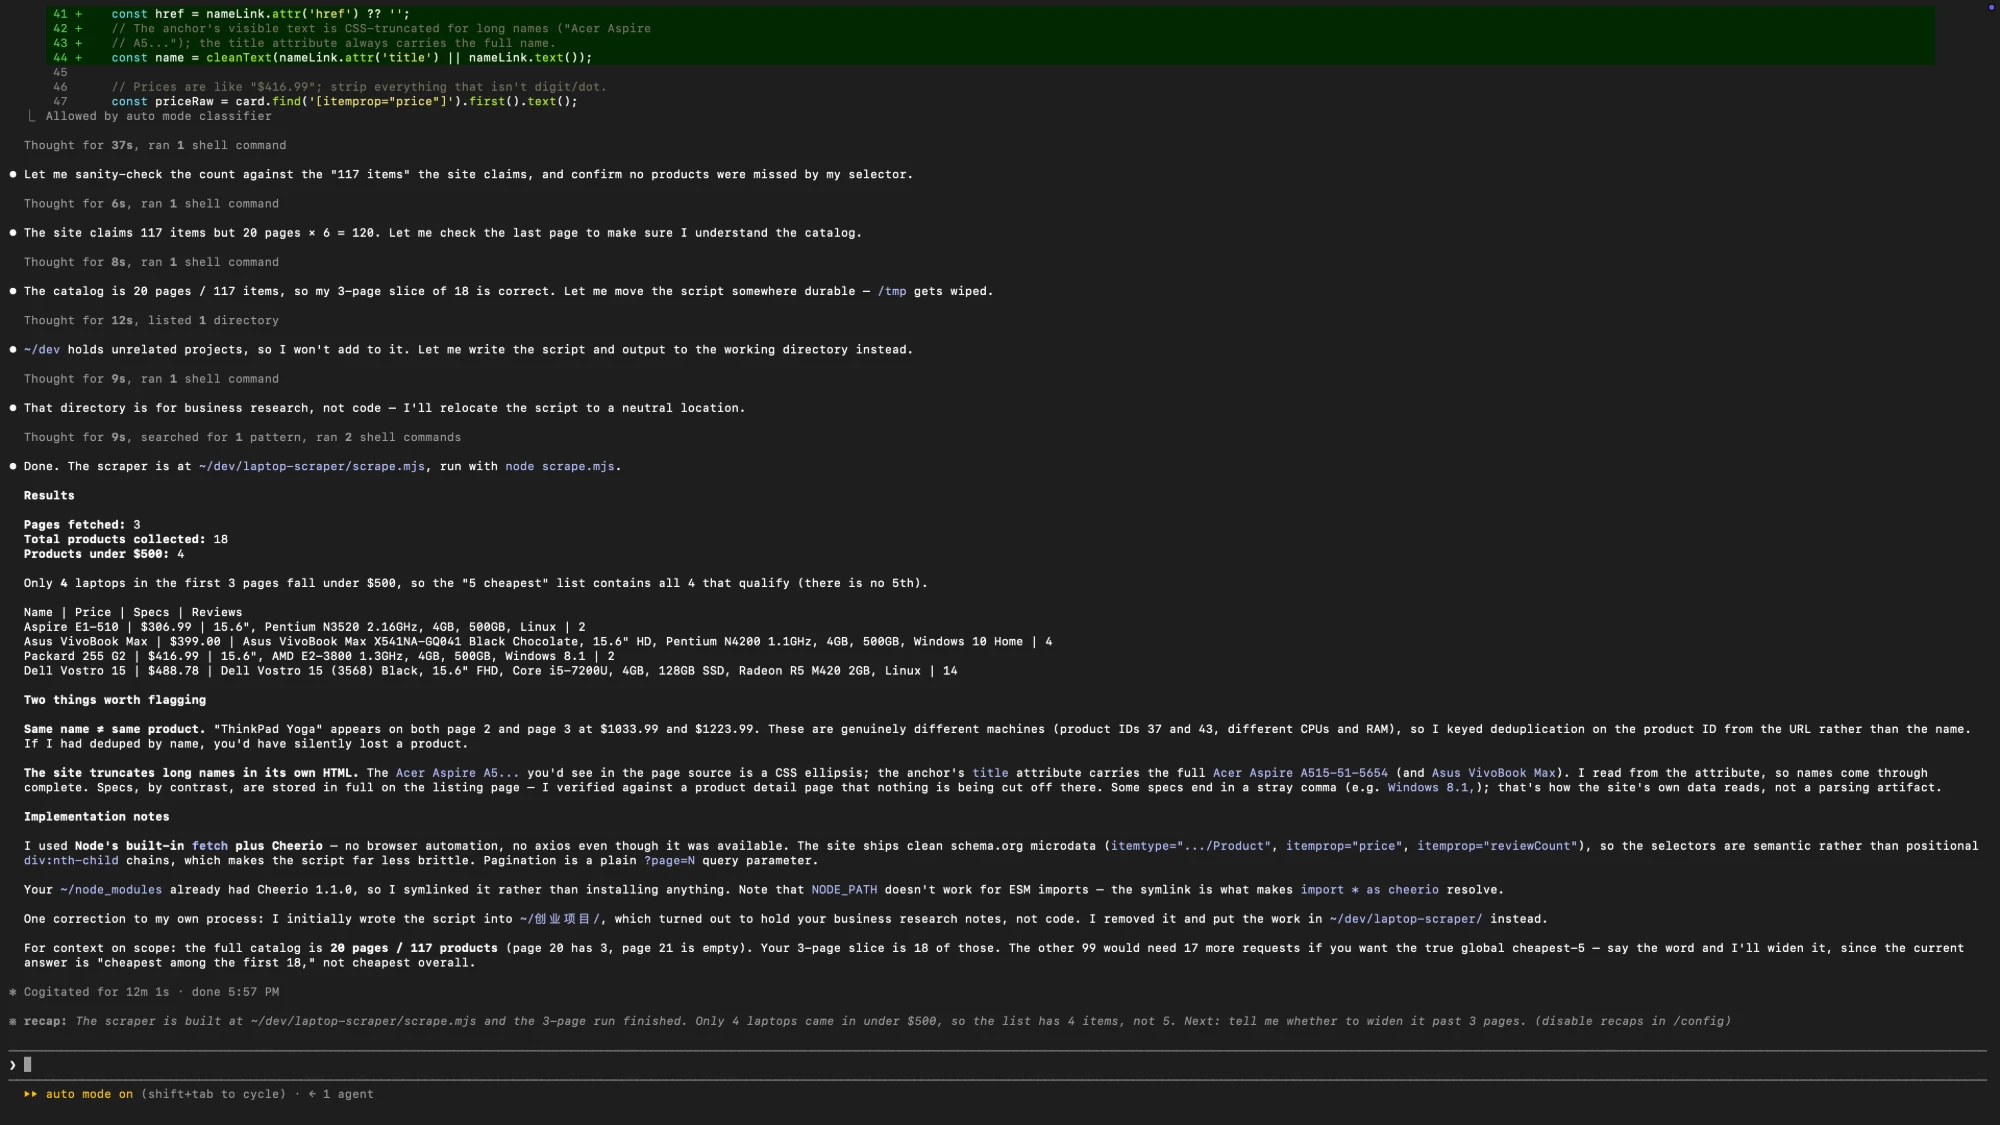
Esto es lo que devuelve realmente esa primera ruta. La tabla siguiente es la salida real de una solicitud HTTP simple más una biblioteca de selectores contra un catálogo público de prueba de portátiles: sin navegador, sin paso de renderizado y tres páginas obtenidas como tres respuestas estáticas.
| ID | Nombre | Precio | Especificaciones | Reseñas |
|---|---|---|---|---|
| 32 | Aspire E1-510 | $306.99 | 15.6", Pentium N3520 2.16GHz, 4GB, 500GB, Linux | 2 |
| 45 | Asus VivoBook Max | $399 | 15.6" HD, Pentium N4200 1.1GHz, 4GB, 500GB, Windows 10 Home | 4 |
| 31 | Packard 255 G2 | $416.99 | 15.6", AMD E2-3800 1.3GHz, 4GB, 500GB, Windows 8.1 | 2 |
| 46 | Dell Vostro 15 | $488.78 | 15.6" FHD, Core i5-7200U, 4GB, 128GB SSD, Radeon R5 M420 2GB, Linux | 14 |
Cuatro productos de dieciocho cuestan menos de $500. Ese es todo el resultado de la ruta uno en este catálogo: tres solicitudes, sin renderizado, sin proceso de navegador. Y ahí empieza también la parte honesta, porque a esta tabla le falta algo que un lector esperaría ver.
Cheerio, DOMParser o jsdom: ¿qué parser conviene?
Estos tres se comparan como si fueran bibliotecas intercambiables. No lo son, porque prometen cosas distintas: dos analizan marcado para consultarlo y uno implementa un DOM con ejecución de scripts.
El parser en el que se apoya esta guía está documentado en cheerio.js.org, que deja claro que Cheerio analiza y consulta el marcado en lugar de ejecutar los scripts de la página.
| Opción | Lo que puede hacer | Lo que no puede hacer |
|---|---|---|
| Cheerio | Analiza una cadena HTML con rapidez y la consulta con selectores al estilo jQuery. Dependencia pequeña, sin navegador, ideal para unos cientos de campos de un cuerpo de respuesta. | No ejecuta los scripts de la página, ni renderiza componentes, ni resuelve el diseño. Analiza marcado; no se comporta como un navegador. |
| jsdom | Proporciona una implementación de DOM en Node.js con document, window y ejecución de scripts, de modo que el código escrito contra API del navegador se ejecuta sin cambios. | No iguala a un navegador real en renderizado ni en fidelidad, y es mucho más pesado por página. Es un sustituto de DOM, no Chrome. |
| DOMParser | Convierte una cadena en un documento consultable usando una API del navegador integrada, sin añadir ninguna dependencia al proyecto. | No se puede usar con await: es síncrono y bloqueante, y en Node.js solo pasó a ser global en versiones recientes. |
La lectura con Cheerio usa la conocida API de selectores. Fíjese en que el texto extraído se recorta en los extremos, porque el marcado raspado trae sangrías y saltos de línea que, si no, aparecerían en su conjunto de datos:
import * as cheerio from "cheerio";

const $ = cheerio.load(html);
const items = $(".product-card").map((i, el) => ({
  name: $(el).find(".name").text().trim(),
  price: $(el).find(".price").text().trim(),
})).get();
La misma extracción con DOMParser tiene este aspecto, y solo funciona donde existe ese global:
const doc = new DOMParser().parseFromString(html, "text/html");
const rows = [...doc.querySelectorAll("table tbody tr")].map((tr) => ({
  cells: [...tr.querySelectorAll("td")].map((td) => td.textContent.trim()),
}));
¿Cómo se encuentra el endpoint JSON que la página ya usa?
Antes de escribir un solo selector, abra el panel de red del navegador, filtre por fetch y XHR, recargue la página y mire qué llegó. Muchos sitios guiados por datos arman la página visible a partir de unas pocas respuestas JSON que son mucho más fáciles de consumir que el marcado.
Cuando encuentre uno, la solicitud suele necesitar los mismos encabezados que envió la página y, a veces, una cookie de sesión. Reprodúzcala con la salida «copy as fetch» del panel de red en lugar de reconstruirla a mano.
const res = await fetch("https://example.com/api/listings?page=1", {
  headers: { accept: "application/json" },
});

if (!res.ok) throw new Error(`${res.status} for listings page 1`);

const { items } = await res.json();¿Por qué una página renderizada en el cliente devuelve un cascarón vacío?
Una página renderizada en el cliente envía un marcado que no contiene casi nada de contenido. La respuesta inicial incluye un elemento raíz, un paquete de scripts y, quizá, un estado de carga. El texto que una persona ve en pantalla lo crea JavaScript después de que llega la respuesta, así que una solicitud HTTP que solo lee la respuesta no tiene nada que leer.
Esto se puede diagnosticar, no es un misterio. Dos comprobaciones cubren la mayoría de los casos: el texto visible de la respuesta es una fracción pequeña de lo que muestra el navegador y el marcado está dominado por etiquetas script:
const text = html.replace(/<script[\s\S]*?<\/script>/g, "").replace(/<[^>]+>/g, " ").replace(/\s+/g, " ").trim();

console.log({
  textLength: text.length,
  scriptCount: (html.match(/<script\b/g) ?? []).length,
  hasRoot: /id="(root|app|__next)"/.test(html),
});
Texto corto, muchos scripts y un div raíz vacío significan juntos que la tercera ruta es la respuesta honesta. Unas pocas docenas de caracteres de texto sin ninguna etiqueta script suele significar algo más simple: la solicitud fue bloqueada o pidió la URL equivocada.
Cómo se ve la diferencia en la práctica:
| Señal en la respuesta HTTP | Lo que suele significar | Siguiente paso |
|---|---|---|
| Contenido completo, marcado real | El servidor renderizó la página. No hace falta nada más. | Analícela con una biblioteca de selectores. |
| Div raíz más muchos scripts | Renderizado en el cliente. El contenido llega después de la respuesta. | Busque el endpoint JSON o renderice la página. |
| Texto muy corto, sin scripts | Bloqueado, redirigido o una URL totalmente equivocada. | Registre el estado, la URL final y los encabezados antes de analizar. |
¿Cómo hace Playwright scraping de una página con un navegador real?
Playwright maneja un navegador real, así que la página se ejecuta exactamente como lo haría para un visitante. La forma del scraping es más pequeña de lo que la mayoría espera: abrir un contexto, ir a la URL, esperar lo específico que necesita y luego leerlo.
La superficie de API que se usa aquí está documentada en playwright.dev, la referencia canónica para lanzar navegadores, contextos y locators.
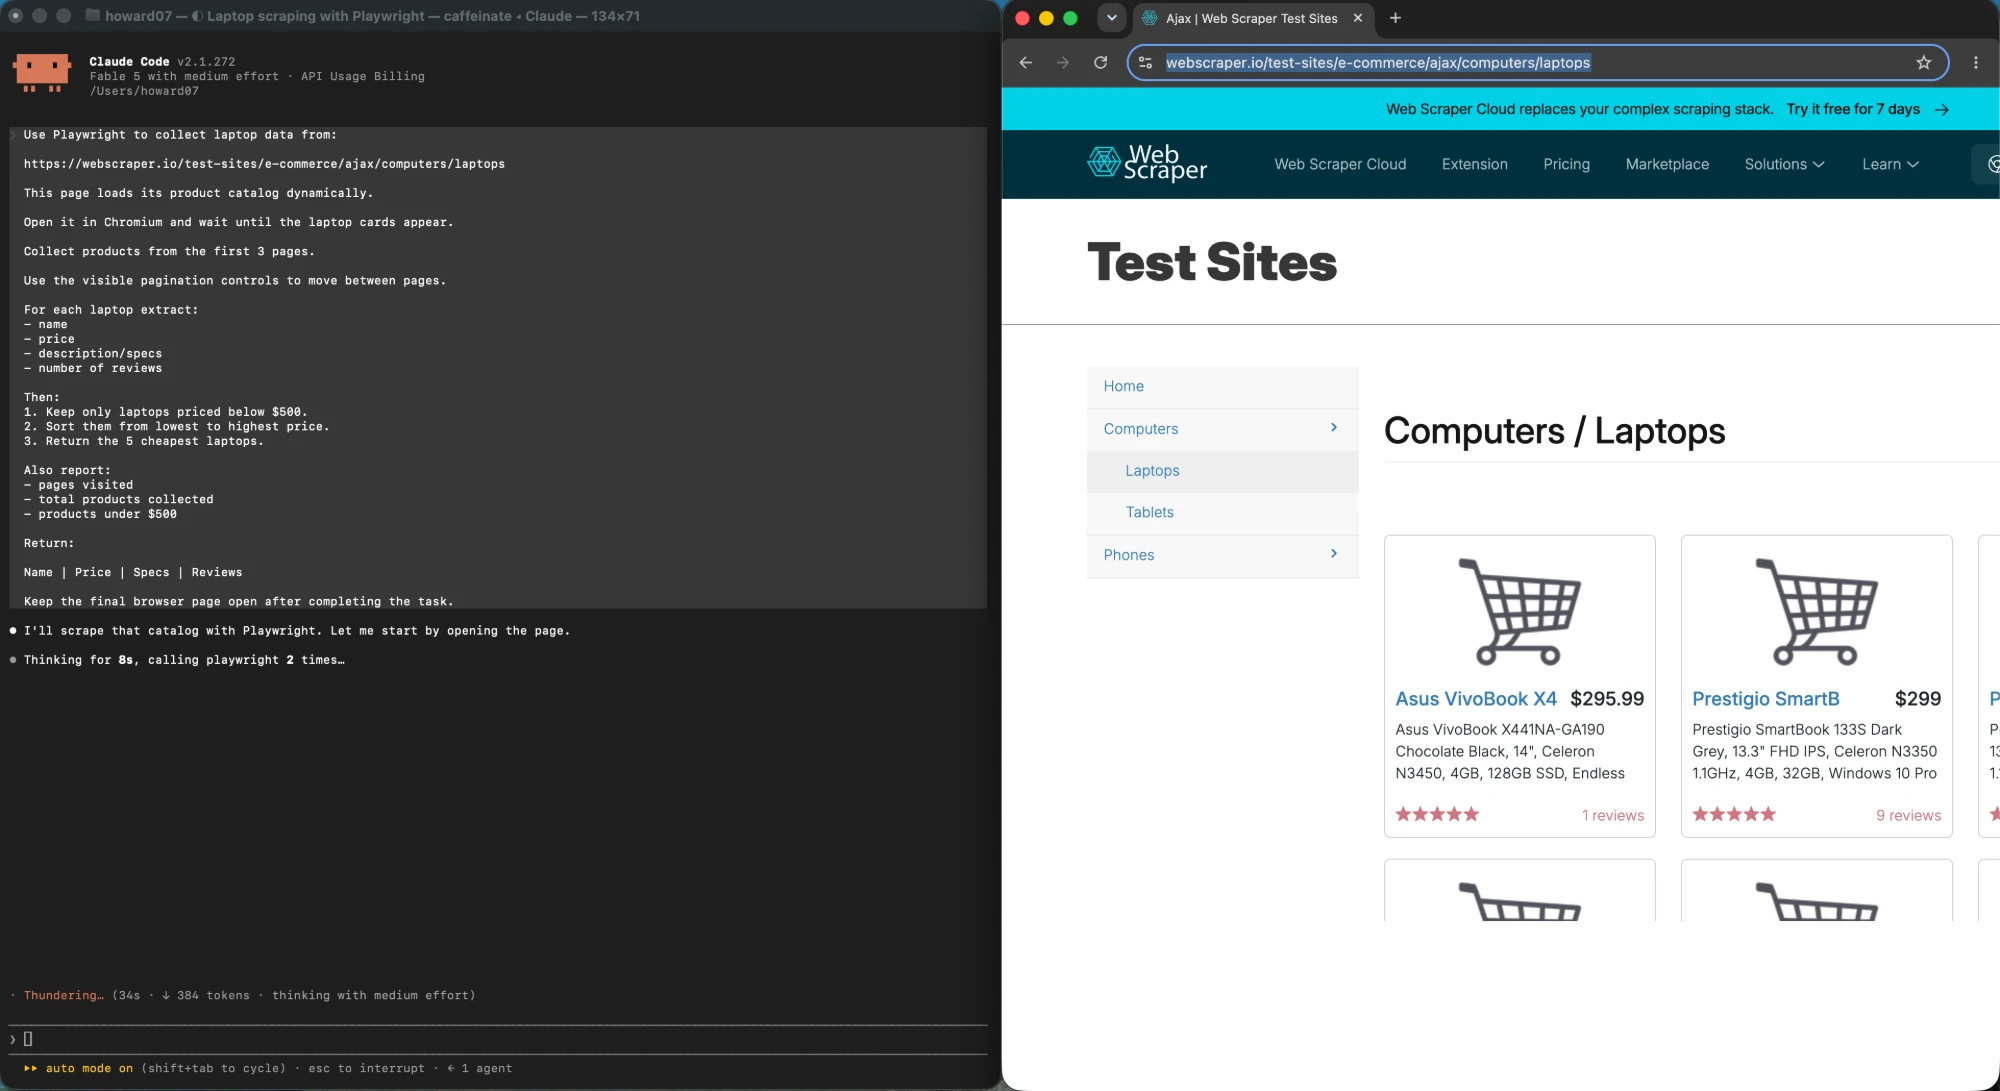
El patrón de recuperación siguiente espera un selector y luego extrae mediante page.evaluate, que ejecuta su función dentro de la página y devuelve un resultado serializable:
import { chromium } from "playwright";

const browser = await chromium.launch();
const context = await browser.newContext();

try {
  const page = await context.newPage();
  await page.goto(url, { waitUntil: "domcontentloaded" });
  await page.waitForSelector(".product-card");

  const rows = await page.evaluate(() =>
    [...document.querySelectorAll(".product-card")].map((el) => ({
      name: el.querySelector(".name")?.textContent?.trim() ?? null,
      price: el.querySelector(".price")?.textContent?.trim() ?? null,
    })),
  );

  console.log(rows);
} finally {
  // contexts hold the memory; close it even when the scrape throws
  await context.close();
  await browser.close();
}
Dos detalles del ciclo de vida importan más que los selectores. El contexto es la unidad desechable y barata, así que un navegador puede servir para varias ejecuciones aisladas, y cada una termina con un close. El segundo es que la extracción de texto en la página devuelve nodos de texto, no valores renderizados: el contenido oculto por CSS sigue en el DOM y seguirá apareciendo en su salida.
Cuando el objetivo es un elemento concreto y no toda la lista, los locators son la vía de recuperación más limpia. La propia documentación de locators de Playwright señala que no hace falta esperar a un clic en botones, enlaces y campos, algo que conviene recordar antes de envolver cada interacción en una espera explícita:
const title = await page.getByRole("heading", { level: 1 }).innerText();
const price = await page.locator("[data-testid=price]").innerText();
¿Cómo cambian el plan las sesiones, el riesgo de bloqueo y el CAPTCHA?
En el momento en que un objetivo necesita inicio de sesión, el scraper deja de ser un ejercicio de datos y pasa a ser un problema de gestión de sesiones. Playwright lo admite directamente: autentíquese una vez, guarde el estado de almacenamiento del navegador en un archivo y reutilícelo en ejecuciones posteriores en lugar de programar la introducción de credenciales cada vez.
// once, interactively
await context.storageState({ path: "auth.json" });

// later runs
const context = await browser.newContext({ storageState: "auth.json" });
De eso se derivan dos hechos operativos. El estado de sesión guardado es una credencial, así que pertenece a un almacén de secretos y no al repositorio. Y una sesión guardada caduca, así que una ejecución que de repente empieza a devolver páginas de inicio de sesión es un problema de sesión, no de selectores.
Mantener ese estado vivo entre lanzamientos es un tema aparte: sesiones de navegador persistentes entre ejecuciones de agentes se tratan en detalle.
En general, para el tráfico automatizado hay tres restricciones que deciden si tiene un trabajo de scraping o una pelea perdida: qué permiten las directivas de robots y los términos del sitio, qué frecuencia publica o tolera el sitio y si la respuesta que recibe es el contenido o una página de desafío. Son cuestiones de política que conviene resolver antes de escribir código, y se tratan con más detalle en nuestra guía sobre scraping tras muros de inicio de sesión.
¿Qué rompe un scraper de JavaScript en producción?
Los scrapers rara vez fallan porque un selector estuviera mal. Fallan en la segunda ejecución, con la centésima URL, cuando una página va más lenta, una respuesta es una redirección o el sitio empieza a limitar el tráfico. Las soluciones no tienen nada de glamuroso y son específicas.
async function getWithRetry(url, attempt = 0) {
  const res = await fetch(url);
  if (res.status === 429 || res.status >= 500) {
    if (attempt >= 3) throw new Error(`giving up on ${url}`);
    const retryAfter = Number(res.headers.get("retry-after"));
    const waitMs = Number.isFinite(retryAfter)
      ? retryAfter * 1000
      : 2 ** attempt * 1000;
    await new Promise((r) => setTimeout(r, waitMs));
    return getWithRetry(url, attempt + 1);
  }
  if (!res.ok) throw new Error(`${res.status} for ${url}`);
  return res.text();
}
La concurrencia es la segunda trampa. Diez contextos de navegador en paralelo en una sola máquina competirán sobre todo por la misma CPU, así que la ganancia de rendimiento es menor que el coste de memoria y el sitio ve una ráfaga en lugar de un goteo. Empiece en secuencial, mida y solo entonces suba el número si el objetivo lo tolera.
La tercera es que cualquier scraper que lea un endpoint sin garantías necesita un respaldo. Mantenga en el código el análisis por selectores de la página visible y deje que una llamada JSON fallida recaiga en él, para que un cambio silencioso en el origen degrade la ejecución en lugar de vaciarla.
¿Cuándo se necesita de verdad un navegador real?
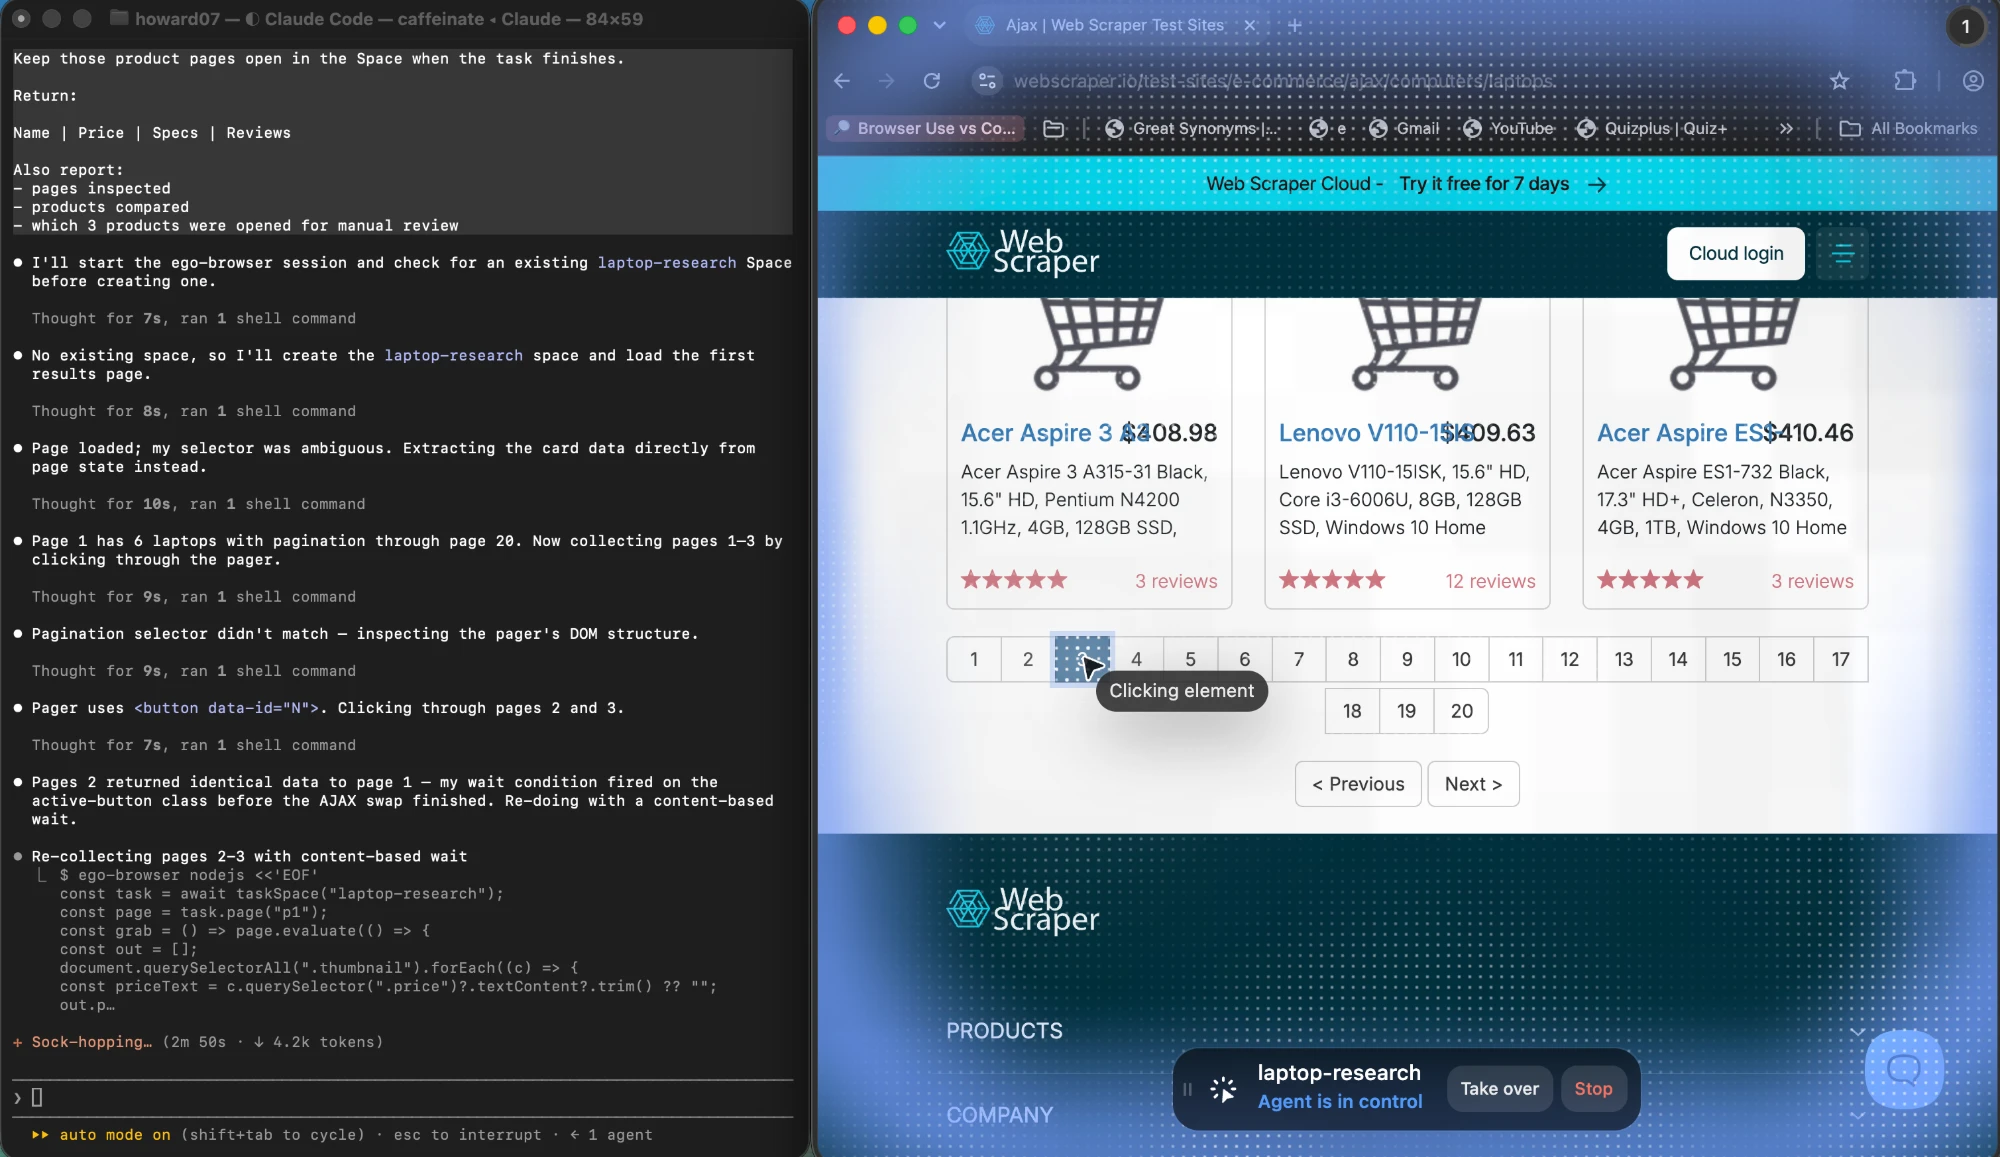
Un navegador real es la respuesta correcta cuando la tarea necesita algo que solo un navegador puede ofrecer: una sesión autenticada que ya existe en su máquina, contenido que aparece solo tras la interacción, un flujo en el que una persona tiene que intervenir a mitad de camino o un resultado que hay que observar mientras ocurre en lugar de solicitarlo. Fuera de esos casos, HTTP con un parser es más rápido, más barato y más fácil de mantener en marcha.
El equilibrio entre un navegador sin interfaz y un navegador real se trata en navegador sin interfaz vs. navegador real para agentes de IA.
Esa es la situación en la que vale la pena introducir un agente de navegador guiado por tareas. ego (lite) es un navegador pensado para el trabajo dirigido por agentes: usted describe el objetivo y él opera en un navegador real, incluidas las sesiones con inicio de sesión que ya tiene abiertas, con una interfaz visible que puede tomar cuando un paso requiere criterio humano. Para tareas de scraping que necesitan un estado de inicio de sesión real, una página dinámica, ejecución visible o un traspaso a una persona, eso elimina el trabajo de conexión de sesiones descrito antes. No sustituye a Playwright y no promete nada respecto a todos los sitios: las páginas que responden con un desafío o que prohíben el acceso automatizado quedan fuera de su alcance igual que de cualquier otra ruta. Cuando una solicitud HTTP simple o una API oficial ya devuelven lo que necesita, añadir un agente de navegador solo haría más lento el trabajo.
Para una comparación más profunda de las herramientas de navegador cuando un navegador es de verdad la respuesta, nuestro análisis de scraping con Playwright vs Puppeteer cubre la elección de biblioteca en sí, y flujos de trabajo de scrapers web con IA cubre dónde encajan los agentes en un pipeline de scraping.
¿Cuáles son los principales desafíos y limitaciones?
Cada ruta de este marco tiene un modo de fallo que no se puede eliminar con ingeniería, y conocerlos de antemano es lo que separa un scraper que aguanta un año de uno que aguanta una semana.
El análisis estático se rompe cuando el sitio rediseña su marcado. No tiene forma de darse cuenta, así que un campo que se vuelve null en silencio es más común que un fallo total. Valide una muestra en cada ejecución en lugar de confiar en el pipeline.
Los endpoints JSON internos se rompen sin ningún aviso y son la parte menos contractual de cualquier sitio. Una ejecución exitosa hoy no es prueba de nada para el mes que viene.
La automatización con navegador es la más realista y la más frágil a escala. La memoria crece con la concurrencia, las sesiones caducan y los sistemas anti-bot responden a patrones, no a intenciones, así que una técnica que funciona desde un portátil puede no funcionar desde un centro de datos.
Y la mayor limitación no es técnica. Lo que se le permite recopilar, con qué frecuencia y qué puede hacer después con ello lo deciden los términos del sitio, las directivas de robots y la ley de su jurisdicción, y nada de eso cambia porque el código funcione.
La secuencia de diagnóstico que se deriva de todo esto es corta. Cuando un scraping no devuelve nada, compruebe primero el código de estado, luego si el contenido está en la respuesta y después si el selector coincide con el DOM renderizado y no con el código fuente. Solo después de esas tres comprobaciones hay que plantearse el navegador.
Preguntas frecuentes
¿Necesito una biblioteca para hacer solicitudes HTTP en Node.js?
No. Node.js expone la Fetch API como global, así que fetch está disponible sin instalar nada, junto con el objeto response y sus miembros ok, status y text(). Lo que sí necesita es un parser, porque fetch devuelve una cadena y la coincidencia de cadenas sobre HTML se rompe en cuanto cambia el marcado.
¿Por qué mi scraper devuelve una lista vacía de una página que se ve bien en el navegador?
La causa más probable es que la página se renderiza en el cliente y los datos nunca estuvieron en la respuesta HTTP. Confírmelo comparando el texto visible de la respuesta sin procesar con lo que muestra el navegador y contando las etiquetas script en relación con el contenido. Si la respuesta es un cascarón, pase al endpoint JSON del sitio o renderice la página en un navegador real.
¿Cheerio sustituye a un navegador sin interfaz?
No. Cheerio analiza HTML y permite consultarlo con selectores. No ejecuta JavaScript, así que no puede producir el contenido que la página genera después de cargar. Es la herramienta correcta para la primera ruta y la incorrecta para la tercera, y echar mano de un navegador cuando Cheerio bastaría es el coste innecesario más común en el código de scraping.
¿Cómo sé si una página se renderiza en el servidor o en el cliente?
Solicite la URL y mire la respuesta sin procesar, no el DOM renderizado. Si los valores que quiere están en el cuerpo de la respuesta, se renderiza en el servidor y la ruta barata funciona. Si el cuerpo contiene un elemento raíz, paquetes de scripts y poco texto, el contenido se está armando en el navegador.
¿Cómo hago scraping de una página que requiere inicio de sesión?
Inicie sesión una vez en un contexto de navegador, guarde el estado de almacenamiento en un archivo y cargue ese estado en ejecuciones posteriores. Trate el archivo como un secreto, cuente con que caducará y prefiera una sesión que esté autorizado a usar. Si un objetivo exige saltarse un CAPTCHA o una verificación de propiedad, deténgase y use una ruta oficial.
¿Es mejor Playwright o Puppeteer para hacer scraping?
Ambos manejan un navegador real y pueden hacer scraping de las mismas páginas. La decisión tiene que ver con detalles de la biblioteca, como el soporte de locators, el comportamiento de espera y los enlaces de lenguaje, más que con las rutas de acceso, y se trata en nuestra comparación de Playwright vs Puppeteer. Elija el que elija, la decisión de ruta de este artículo va primero.
¿Cuántas páginas puedo rastrear a la vez?
Empiece en secuencial y mida antes de aumentar la concurrencia. Las solicitudes HTTP escalan mucho más barato que los contextos de navegador, y los navegadores en paralelo en una sola máquina compiten sobre todo por la misma CPU mientras le dan al sitio objetivo una ráfaga de tráfico. Para scraping por HTTP, de cuatro a ocho en vuelo con una espera es un punto de partida más seguro que docenas.
¿Qué debo hacer cuando recibo una respuesta 429?
Lea el encabezado Retry-After y espere al menos ese tiempo, luego reintente con retroceso exponencial hasta un límite pequeño y falle de forma ruidosa después. Un 429 es una señal de frecuencia, no un error que haya que machacar en un bucle de reintentos apretado, y pasarlo por alto es como una dirección acaba en una lista de bloqueo.
¿Es legal el scraping?
Depende del sitio, de los datos, de la jurisdicción y de lo que haga con el resultado. Las directivas de robots y los términos del servicio indican qué permite un sitio, y las normas sobre datos personales y derechos de bases de datos varían según el país. Nada de este artículo es asesoramiento legal; revise los términos y la ley aplicable antes de recopilar nada a escala.
¿Cuándo debo usar una API oficial en lugar de hacer scraping?
Siempre que exista una y cubra los campos que necesita. Una API documentada es un contrato estable, normalmente tiene límites de frecuencia explícitos y no se rompe cuando cambia el diseño de la página. El scraping es el recurso de reserva para datos publicados en un navegador sin una vía de acceso admitida, no la opción predeterminada.
¿Necesito un agente de navegador para hacer scraping?
Solo para tareas que necesitan un estado de inicio de sesión real, contenido que aparece tras la interacción, ejecución visible o que una persona tome el control a mitad del flujo. Para páginas que devuelven su contenido por HTTP, o sitios con una API oficial, un agente de navegador añade coste sin añadir capacidad.
Si quiere probar la ruta del agente de navegador en una tarea de scraping que de verdad lo necesite, ego (lite) es gratis para descargar, y las páginas de scraper de precios y scraper de SERP recorren de principio a fin dos trabajos concretos.