简短回答:Playwright 当前文档指出,MCP 的上下文成本更高,因为工具 schema 和快照都会进入对话;而 CLI 使用简洁的 shell 命令、按需加载 skill,因此更适合编码 Agent,成本更低。官方并没有给出一个通用的百分比。社区历史上的测试曾在两个具体任务上报告过大约 4 倍的差距,但这些数字不是官方基准,不能当作预算预测来用。
Playwright CLI 也可以使用持久化的或显式配置的登录态。
一位 Reddit 用户用一句话概括了 Playwright MCP 的体验:只跑了一两次浏览器测试,Claude Code 的对话就被压缩了,因为上下文已经满了。
这个反馈与快照密集型工作流中一个已知的取舍相符。Playwright MCP 是一个协议服务器,它通常会在浏览器操作后返回结构化的无障碍信息,而在真实页面上,这些响应可能非常大。
Playwright 官方如何说明 MCP 与 CLI 的区别?
Playwright 当前的 MCP 文档明确划定了产品边界:MCP 最适合专门的 Agent 循环和探索性自动化,而 CLI 最适合与大型代码库一起工作的编码 Agent。同一份对比还把 MCP 的 Token 成本标为更高,因为工具 schema 和快照会进入上下文;把 CLI 的成本标为更低,因为它的输出简洁,且技能按需加载。
把当前的官方 MCP 对比当作决策规则,而不是基准测试结果。它没有公布固定的倍数,而且当前的 MCP 和 CLI 版本都有一些旧对比没有评估过的控制项。页面形态、启用的工具、快照策略、客户端行为以及操作次数都会改变账单。
两次历史上的社区测量指向了同一个方向。一篇文章引用了一次 MCP 运行 114K Token,对比 CLI 的 27K,随后又在另一个 8 步登录加仪表盘测试中报告了约 89K 对 24K。这些任务、版本、模型客户端和测量方法都没有标准化,所以只能在同一对数据内部比较。
Medium 上的一位测试工程师随后自己在一个 8 步任务上做了并排对比(登录预发布应用、打开分析仪表盘、验证三张 KPI 卡片、点进一份报告、截图),结果 MCP 约为 89K Token,CLI 为 24K。
历史上的社区 Token 测量
Two task-specific comparisons, not an official Playwright benchmark
在那篇文章中,两对数据都接近 4 倍。唯一站得住脚的结论是方向性的:接口和证据策略会实质性影响上下文用量。请测量你实际运行的版本和页面形态。
MCP 的 Token 到底花在哪里?
历史上的 8 步测量之所以有用,是因为它逐项列出了一份账单。它的数值描述的是那套设置,而不是当前 Playwright 的默认值,也不代表所有 MCP 客户端。
首先是报告中的固定成本:那个 MCP 客户端加载了二十多个工具 schema,测得约 4,200 Token,而它的 CLI 路径只读取了一份 68 Token 的帮助信息。工具发现和缓存因客户端和版本而异,所以这些不是包的常量。
其次是报告中的每步成本:被测流程在操作后返回无障碍树。作者测得登录表单约 3,800 Token,仪表盘 12,000 Token,随后还提到更大的企业页面。当前的 Playwright MCP 可以用 browser_find 搜索快照、把快照写入文件、限制其深度,或者把快照模式设为 none。这些控制项可以实质性改变结果。
当前的官方 MCP 命令参考把 browser_find 描述为在已知目标文本时比返回整个快照更便宜。这现在是完全禁用快照之前应该首先尝试的优化。
我们在 2026 年 8 月自己测量过这一点,用的是另一个基于相同无障碍快照模式的 MCP 服务器(Chrome DevTools MCP,不是 Playwright MCP,因为那是我们手头有现成测试环境的那个),以便亲眼看到单次快照调用的实际字节成本。在一个中等复杂度的页面,也就是 Hacker News 首页上,一次 take_snapshot 调用返回了 38,285 个字符,约 9-10K Token,而这只是一次快照:
import asyncio
from mcp import ClientSession, StdioServerParameters
from mcp.client.stdio import stdio_client

async def main():
    params = StdioServerParameters(
        command="npx",
        args=["--yes", "chrome-devtools-mcp@latest", "--headless", "--isolated"],
    )
    async with stdio_client(params) as (read, write):
        async with ClientSession(read, write) as session:
            await session.initialize()
            nav = await session.call_tool("navigate_page", {"url": "https://news.ycombinator.com/"})
            print("navigate_page chars:", len("".join(c.text for c in nav.content if hasattr(c, "text"))))

            snap = await session.call_tool("take_snapshot", {})
            snap_text = "".join(c.text for c in snap.content if hasattr(c, "text"))
            print("take_snapshot chars:", len(snap_text))
            print(snap_text[:700])

asyncio.run(main())
navigate_page chars: 123
take_snapshot chars: 38285
## Latest page snapshot
uid=1_0 RootWebArea "Hacker News" url="https://news.ycombinator.com/"
uid=1_1 link url="https://news.ycombinator.com/"
uid=1_2 link "Hacker News" url="https://news.ycombinator.com/news"
uid=1_3 StaticText "Hacker News"
uid=1_4 link "new" url="https://news.ycombinator.com/newest"
uid=1_5 StaticText "new"
uid=1_6 StaticText " | "
uid=1_7 link "past" url="https://news.ycombinator.com/front"
uid=1_8 StaticText "past"
uid=1_9 StaticText " | "
uid=1_10 link "comments" url="https://news.ycombinator.com/newcomments"
uid=1_11 StaticText "comments"
uid=1_12 StaticText " | "
uid=1_13 link "ask" url="https://news.ycombinator.com/ask"
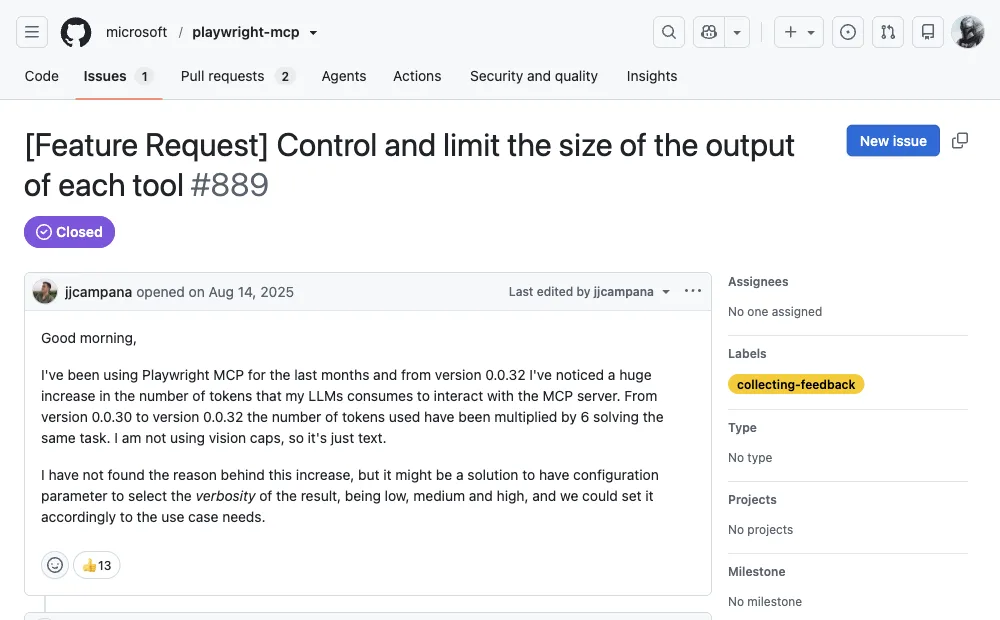
...一个历史 issue 说明了版本变化为何重要。Issue #889在 microsoft/playwright-mcp 仓库中,Issue #889 报告了同一个任务在两个小版本之间 Token 消耗翻了 6 倍,并请求增加一个详细程度(verbosity)设置。该 issue 已关闭,当前版本提供了更精细的快照控制选项。请把它当作版本敏感测量的历史证据,而不是对今天默认行为的描述。
上下文计量会随着反复观察而增长。
为什么每多一步,差距就更大?
短任务可能看不出明显差别。差距会在多步任务中拉开:MCP 的完整快照不断累积进对话,而 CLI 的产物留在磁盘上,Agent 只读取其中很小一部分。当 MCP 使用 browser_find 或限制深度的快照时,差距也会缩小;反过来,如果 CLI Agent 把每个产物都读回上下文,差距同样会缩小。
在社区作者实测的那次会话中,据称到第 12 至 15 步时,Agent 已经携带了 60-90K Token 的页面状态,随后又引用了更早页面上的某个元素。该作者的 CLI 工作流把快照写到磁盘,只读取选定的输出。这是一种历史性的失败模式,并不是 Playwright 承诺的阈值。
多步任务中上下文 Token 是如何堆积的
MCP commonly returns page observations per step; the CLI writes artifacts to files and can read back only what it needs
这个变通做法值得停下来想一想。当用户不约而同地得出“让 Agent 写代码,而不是调用 MCP 工具”这个结论时,他们选择的其实是一条面向文件和 shell 的路线,和 CLI 很接近。
什么情况下仍然应该选 Playwright MCP?
公平的对比必须说明 MCP 在哪些方面更好,因为确实存在一些场景,即便要付出 Token 代价,它也是正确的选择。
| 场景 | 更合适的路线 | 原因 |
|---|---|---|
| Agent 没有 shell 或文件系统访问权限(Claude Desktop、沙箱客户端) | MCP | CLI 没有 shell 就跑不起来。MCP 仅靠协议本身就能工作。 |
| 短时间的探索性会话,约 10 步以内 | MCP | 零代码配置,而且完整页面结构进入上下文有助于模型理解不熟悉的页面。 |
| 不会写代码的 Agent(纯对话式 Agent) | MCP | 工具调用可能是唯一可行的接口;CLI 则假定有 shell 和文件访问权限。 |
| 长任务,15 步以上,或浏览器操作与编码混在一起 | CLI | 快照堆积会给长时间的 MCP 会话带来压力;CLI 在选择性读取产物时,上下文可以保持得更小。 |
| 对成本敏感的大规模工作负载 | CLI | 上下文 Token 大约减少 4 倍,可以降低浏览器部分的模型输入成本,但账单还取决于模型定价、输出 Token、重试次数以及具体工作负载。 |
| 需要登录自己账号的任务 | 两者都可以,但需要明确配置 | CLI 可以持久化浏览器配置文件(Profile)、加载 storage state、通过 Playwright 扩展程序接入,或经 CDP 连接到 Chrome/Edge。MCP 支持持久化或隔离的浏览器配置文件(Profile)、storage state,以及它自己的浏览器扩展程序。两条路线都需要明确的授权和浏览器配置文件(Profile)处理。 |
MCP 的诚实卖点是方便与兼容:一行配置,许多支持 MCP 的客户端无需写代码就能用。对于短任务,这种便利是值得的;但在用于长流程之前,先衡量一下上下文成本。
走 CLI 这条路需要准备什么?
官方 CLI 是@playwright/cli,由 Playwright 团队专门为解决这个问题而发布。安装配置只需两条命令:
npm install -g @playwright/cli@latest
playwright-cli install --skills   # installs agent skills for Claude Code / Copilot

playwright-cli open https://example.com
playwright-cli snapshot           # refs like e15, saved to disk
playwright-cli click e15
关键门槛在于 shell 与文件访问权限:Agent 必须能够运行命令、读取文件并组合脚本。Claude Code、Codex、Cursor 和 Copilot 在配置了相应权限后都能做到;纯聊天客户端则可能需要改用支持 MCP 的集成方式。当前官方 CLI README 与 npm 包要求 Node.js 18 或更高版本。
如何在 OpenCode 中使用 Playwright CLI?
OpenCode 可以把官方 Playwright CLI 当作一个可通过 shell 访问的 Skill 来使用。先安装 CLI,在你的 Agent 支持 Skill 时安装其 Skill,然后让 OpenCode 运行 playwright-cli 命令;这条路线不需要注册 Playwright MCP 服务器。最小配置如下:
npm install -g @playwright/cli@latest
playwright-cli install --skills

playwright-cli open https://example.com
playwright-cli snapshot
playwright-cli click e15
如果你的 OpenCode 配置不会自动加载 Skill,就显式给它同样的命令约定:让它先检查 playwright-cli --help,在使用 ref 之前先运行一次快照,并且只在需要时才读取输出文件。CLI 会为当前的内存会话保留 Cookie;当你需要浏览器配置文件在浏览器重启后仍然存在时,加上 --persistent,或者用 -s=project-name 来保持彼此独立的会话。
如果你就是想在 OpenCode 里用 Playwright MCP,那是另一套配置。官方 Playwright MCP README 记录了如下本地服务器条目:
{
  "$schema": "https://opencode.ai/config.json",
  "mcp": {
    "playwright": {
      "type": "local",
      "command": ["npx", "@playwright/mcp@latest"],
      "enabled": true
    }
  }
}
浏览器配置文件还有另一层取舍:除非你配置持久化或附加到已有浏览器,否则 CLI 会启动自己的浏览器配置文件。全新的配置文件没有 Cookie,也没有会话。当任务位于登录墙之后时,应使用经过批准的登录流程、持久化配置文件或 storage state,而不是把凭证复制进提示词。
CLI 能复用已经登录的浏览器吗?
可以。当前的 Playwright CLI 可以通过 Playwright Chrome 扩展程序附加,也可以通过 CDP 附加到正在运行的 Chrome 或 Edge 通道,或者连接到一个 CDP 端点。它的默认会话会把 Cookie 保留在内存中,直到浏览器关闭;--persistent 或 --profile 会把状态保留在磁盘上。把附加的个人配置文件视为敏感访问:要有意识地批准连接,并尽可能使用任务专用的配置文件。
官方会话管理参考文档记录了命名会话、持久化配置文件、扩展程序附加和 CDP 附加。要通过 CDP 附加,浏览器必须显式允许远程调试。
ego (lite) 是若干能感知登录态的路线之一,而不是唯一一条。它本身就是浏览器,所以 Agent 直接驱动它,无需安装扩展程序,也不会留下敞开的远程调试端口。会话过期、MFA、账号权限和站点政策依然适用。
它的 Token 模型比 Playwright CLI 又往前走了一步。不再是每个动作一条 shell 命令,而是由 Agent 写一段简短的 JavaScript 程序,并以 heredoc 形式传入。整个多步流程(打开、等待、提取、循环)都在模型之外、在一轮内执行完毕,只有最终结果回到上下文中:
ego-browser nodejs <<'EOF'
const task = await taskSpace("article release QA")
const page = task.page("p1")
await page.goto("http://127.0.0.1:3013/article/playwright-mcp-vs-cli")
await page.waitForSelector("loc=css:article", { state: "visible" })
await page.cdp("Emulation.setDeviceMetricsOverride", {
  width: 390, height: 844, deviceScaleFactor: 1, mobile: true
})
const result = await page.evaluate(() => ({
  h1Count: document.querySelectorAll("h1").length,
  horizontalOverflow: document.documentElement.scrollWidth > innerWidth,
  failedImages: [...document.querySelectorAll("article img")]
    .filter(img => img.complete && img.naturalWidth === 0).length,
  missingAlt: [...document.querySelectorAll("article img")]
    .filter(img => !img.getAttribute("alt")?.trim()).length
}))
console.log(JSON.stringify(result))
EOF
# observed on September 10, 2026:
{"h1Count":1,"horizontalOverflow":false,"failedImages":0,"missingAlt":0}这不是玩具式的提取。我们在一个 Space 里同时打开了八个文章页面,检查了桌面布局和 390 像素的移动布局,验证了语言标签、canonical、标题层级、图片加载、alt 文本、锚点目标、代码溢出和横向溢出,然后点击文章大纲,确认目标标题进入了视口。本地化页面和全部三个英文页面都通过了这些测试检查。
当目标站点接受经过授权的配置文件导入时,Agent 可以复用该状态,而不必再脚本化地重新登录。会话过期、MFA 和站点政策仍可能中断流程。在我们已发布的 heredoc 与 REPL 基准测试中,这种批处理方式以少 44% 的执行轮次、少 35.5% 的工具调用和低 21.6% 的成本完成了同样的任务,对比对象是逐条命令执行。
那项基准测试只衡量执行方式本身。要看整个技术栈的表现,我们跑了 Real-World Bench:同一套 31 项任务,既在真实生产站点(X、Amazon、Zillow、政府数据门户)上执行,也在确定性的本地站点上执行。所有工具使用同一个模型(gpt-5.6-sol,max effort),由同一位独立评审打分,没有针对单个任务挑数据。playwright-cli 本身就是被测的五个工具之一,所以这是与本文所讲的 CLI 路线的一次直接正面对比。注意范围:被测工具是 playwright-cli,也就是官方 CLI;MCP 服务器没有单独做基准测试。
Real-World Bench:完美完成的任务数,共 31 项
Perfect = every binary rubric passes (up to 6 per task, 154 total); no partial credit
The turn counts explain the gap: playwright-cli averaged 42.8 model turns per task, ego (lite) 30.3, because the heredoc batches what the CLI does one command at a time, and every round trip saved is one fewer chance to derail. The billing consequence: playwright-cli averaged $3.42 per task, and $3.42 per task ÷ 71% completion = $4.82 per completed task, because the misses still show up on the invoice. ego (lite): $1.64 per task ÷ 93.5% completion = $1.75 per completed task. It was also the fastest of the five tools measured, at 398 seconds average per task against playwright-cli's 648. Every session log and judge verdict is public in the ego-browser-benchmark-framework 仓库,所以这里的任何数字你都可以自己复核。
反过来也要说句公道话:ego (lite) 是桌面浏览器。它无法在无头 CI 容器里运行,也不是测试框架,所以当你需要在 CI 中做可重复的无头运行时,它并不合适。它真正适合的场景是你已经掌控的活跃账号,Agent 从你选择导入的登录态开始工作。断言密集的回归测试套件仍然应该交给 Playwright 本身。它的位置是需要用到你自己账号的日常工作。
按任务形态来选,而不是按热度来选: 完整的 ego (lite) 与 Playwright MCP 对比 会逐维度讲清楚,或者 下载 Mac 版 ego (lite) 跑一个真实任务,它是免费的。
如何降低 Playwright 浏览器自动化中的 Token 消耗?
要减少 Playwright 的 Token 消耗,关键是控制返回给模型的证据。维护一套针对具体任务的工具集,用过滤后的快照或定向 locator 代替整页 dump,把重复动作批处理进脚本,把大体积输出写入文件再按需读取。为页面数、动作数、重试次数和 Token 设置上限,让失败的运行能可预期地停下来。
- 先定一份范围约定。 明确 URL、字段和成功条件。编码 Agent 不应该反复重新发现同一个页面,也不应该读取请求范围之外的链接。
- 优先使用定向观察。 当目标已知时,只要求返回某个 locator 的文本、一张小表或某个具体的 DOM 属性。当前 MCP 提供 browser_find,用于匹配文本并返回上下文;当前 CLI 提供 find、元素快照和 --depth。只有在 Agent 必须自行发现页面结构时,才使用完整的无障碍快照。
- 把批处理放到对话之外。 让 CLI 执行一个循环,只输出一份 JSON 或 CSV 结果,而不是让 Claude 为每一行都调用一次浏览器工具。只读取决定下一步所需的那一小段输出。
- 衡量被接受的结果。 记录输入和输出 Token、浏览器动作、重试次数以及通过校验的行数。比较每一条被接受结果的成本,而不是只看 Token 总量。
从成本效率看,什么时候用 MCP,什么时候用 CLI?
当任务短小、偏探索,且能立即从结构化的页面上下文中获益,或者客户端无法执行 shell 命令时,用 MCP。当任务长、重复、对成本敏感,或者与编码混在一起时,用 CLI,因为输出可以留在磁盘上,脚本也能批处理动作。这是一个接口层面的选择,并不代表某一种浏览器引擎天生更便宜。
| 问题 | 优先用 MCP | 优先用 CLI |
|---|---|---|
| Agent 能执行 shell 命令吗? | 不能;可用的接口只有 MCP | 能;脚本和文件都可以用 |
| Agent 需要先发现页面吗? | 通常需要;实时快照更方便 | 只有当脚本需要读取快照时才需要 |
| 任务会跑很多步骤或很多行吗? | 可以跑,但快照上下文会不断累积 | 通常可以;把循环分批并设置检查点 |
| 这个任务是确定性的 CI 测试吗? | 适合起草或探索阶段 | 最适合可重复执行的测试命令 |
如果是混合流程,建议两个都装上:先用 MCP 查看不熟悉的页面,再把稳定的路径改写成 CLI 脚本或 Playwright 测试。如果任务需要用到你已登录的账号,这两种接口都不会自动继承你日常使用的 Chrome;请使用明确授权的持久化浏览器配置文件(Profile),或者使用 ego (lite) 这类浏览器,它可以通过一次点击导入你的 Chrome 配置文件。
如何控制工具膨胀和上下文窗口占用?
把工具 schema 和页面快照都算进上下文预算里。停用不用的 MCP 服务器,只暴露任务需要的命令,裁剪快照或改用定位器限定范围的读取,并定期把运行过程汇总成一个小状态文件。上下文控制是配置和工作流问题;换一个更大的模型,并不会让无限增长的对话记录变便宜。
- 按任务加载工具。 尽量把浏览器、文件系统、部署和设计工具放在不同的配置里。一个从未被调用的工具,在会话开始时依然会占用 schema Token。
- 使用上下文检查点。 把 URL、任务状态、已完成的键、失败项和下一步操作写入文件。当对话记录变得杂乱时,从这个文件开始一个新会话。
- 限制证据体积。 限制每一步的行数、字符数、截图和 trace 保留量。完整产物留档备查,但发给 Claude 的是摘要和相关片段。
Playwright MCP 的快照控制和 CLI 面向文件的工作流,各自做了不同的取舍。请把启用的工具和返回的证据,与具体客户端的上下文窗口对照评估;不要在没有测量自己页面形态的情况下,把社区里的 Token 数字直接抄进生产预算。
如何在本地编码工作流中自动做浏览器验证?
把浏览器验证放在代码改动之后、合并之前,让 Agent 产出一条可复现的命令和一小包证据。本地工作流可以打开应用、跑一条冒烟路径、在失败时截图或保存 trace,并把结果汇总到 pull request 里。只有当环境、测试数据和凭证都可控、且这次运行可以安全重复时,才把它排进定时检查。
- 搭建确定性的测试夹具。 使用本地服务器、预置数据的数据库或测试账号。不要让线上生产账号成为通过/失败证据的唯一来源。
- 跑一份小的冒烟契约。 检查导航、一个关键交互、结果 URL 或 API 响应,以及一条用户可见的断言。探索性笔记要和这道关卡分开存放。
- 把证据附到改动上。 记录 commit、浏览器与 Playwright 版本、命令、耗时,以及失败时脱敏后的 trace 或截图。评审者应当能直接重跑,而不必从聊天记录里还原现场。
定时运行的 CLI 可以带着这些证据开一个 pull request,但不能仅凭 Agent 说“通过了”就合并或部署。涉及外部副作用的改动,仍要走仓库原有的检查流程和人工评审。
安装 Playwright CLI 之后还需要 MCP 插件吗?
安装 Playwright CLI 并不会在技术上取代 Playwright MCP,它们是 Playwright 的两套独立接口。当聊天客户端需要工具调用和实时页面结构、又没有 shell 权限时,保留 MCP;当编码 Agent 能执行命令、持久化产物或批量跑长流程时,用 CLI。两者可以同时安装,但在意上下文成本时,把不用的那个 MCP 服务器关掉。
npm install -g @playwright/cli@latest
playwright-cli --version
playwright-cli --help
CLI 可以打开页面、创建快照、点击 ref、执行脚本、保存输出,并安装 Agent 技能;但它不会自动为你写出一套可长期维护的测试。当你需要断言、fixture、重试、trace 和 CI 报告时,让 Claude 把已经跑通的命令序列改写成 Playwright Test。
先读Playwright CLI 官方指南,再把探索性的 CLI 命令当成回归测试来用。
如何排查 OpenCode 子 Agent 和 provider 的问题?
排查 OpenCode 的浏览器故障要从外到内:先确认模型 provider,再看 subagent 权限,然后是 Playwright 命令,最后才是目标页面。记录下确切的命令、provider 的返回内容和第一个失败的步骤。subagent 调不动工具属于配置问题;工具返回空白页或被拦截的页面,属于浏览器或站点状态问题。
- 先检查 provider 是否正常。 用选定的 provider 和模型跑一次最小补全。先确认 base URL、模型名、凭证、配额和网络链路,再去改 Playwright 的 flag。
- 检查 subagent 权限。 确认 subagent 能执行 shell 命令、读取输出目录,并访问已配置的 MCP 服务器。权限要收窄,并检查生成的配置,而不是把所有工具都授权出去。
- 缩减到单个浏览器步骤。 运行 playwright-cli --help,打开一个静态页面,取一次快照,检查原始输出。这样可以把接线问题与 React 外壳、登录墙或反爬响应区分开。
- 记录第一个错误。 保存 stderr、HTTP 状态码、URL、浏览器版本,以及最后一个成功的操作。遇到频率限制或认证被拒时不要反复重试,交给人工或改用获批的替代方案。
使用自定义 provider 时,先证明它的 API 能独立应答,再接入 OpenCode,最后才接 Playwright。一次只加一层,才能避免“provider 不可用”“subagent 被拒”“页面被拦截”全都塌缩成同一个误导性的浏览器报错。
如何把本地 Ollama 模型接入 OpenCode?
把 Ollama 接到 OpenCode 的做法是:先跑本地模型,确认它的 API 端点和模型标识,再把该 provider 加进 OpenCode,最后才挂上 Playwright。在模型能稳定调用一个工具之前,浏览器测试保持最小规模。本地推理可以降低 API 开销,但成本会转移到内存、延迟、上下文长度和模型可靠性上。
- 先单独验证 Ollama。 启动本地服务器,列出已安装的模型,并通过其文档中的 API 发一条短提示。确认该模型支持你的工作流所需的工具调用或结构化输出行为。
- 添加一条 OpenCode provider 配置。 使用该 provider 当前的 OpenCode schema,把 base URL、模型名和可选的 key 放在环境变量或密钥存储里。不要把密钥粘贴到浏览器提示中,也不要提交到仓库。
- 测试一个 Playwright 动作。 打开一个本地或静态页面,检查一个 locator,返回一个结构化值。如果失败,先看 provider 的返回内容,再去改浏览器 flag 或增加工具。
要预期到取舍:较小的本地模型可能需要更紧的提示词和更明确的 selector;较大的本地模型需要更多内存,速度也可能更慢。用完成率、工具调用重试次数、实际耗时和整机成本与托管方案做基线对比,不要想当然地认为本地就等于免费。
FAQ
Playwright CLI 比 Playwright MCP 更快吗?
Playwright 官方把 CLI 描述为对编码 Agent 而言 Token 成本更低,但并没有承诺固定的提速幅度。有一篇早期的社区文章报告,在两个特定任务上上下文差异接近 4 倍。实际耗时取决于浏览器操作、模型往返、重试次数,以及 Agent 读取了多少证据,所以请针对自己的工作流实测。
为什么 Playwright MCP 消耗这么多 Token?
官方对比指出,工具 schema 和快照是主要来源。在一次历史社区测量中,schema 约为 4,200 Token,两个页面快照分别约为 3,800 和 12,000。这些并非当前默认值。建议使用 browser_find、限制深度的快照或元素快照,并结合客户端自身的 Token 报告来测量你实际运行的工作流。
Playwright CLI 可以和任何 AI Agent 一起用吗?
可以配合能执行 shell 命令并读取文件的 Agent 使用,例如 Claude Code、Codex、Cursor,或按相应方式配置的 Copilot。纯聊天客户端需要另一种集成方式,例如支持 MCP 的路径。
这两种方式能在需要登录的网站上使用吗?
默认情况下,每种方式都从各自的浏览器状态启动。Playwright CLI 可以保留内存中的会话,用 --persistent 保存浏览器配置文件(Profile),加载 storage state,或通过其扩展程序或 CDP 附加。Playwright MCP 可以使用持久化的 user-data 目录、storage state 或其浏览器扩展程序。请有意地配置并授权这些路径。
Real-World Bench 的数字是如何测量的?
31 项任务的测试套件在真实生产网站上运行。任务由独立的评审 Agent 根据最多 6 项二元评分标准(整套共 154 项)评分,该 Agent 会自行读取原始会话日志和截图;只有所有评分标准都通过,任务才算完美。五个工具均使用相同的模型(gpt-5.6-sol,最高强度)。playwright-cli 在 31 项任务中完美完成了 71.0%;ego (lite) 在 31 项任务中完美完成了 93.5%。被测的 Playwright 工具是 playwright-cli,而非 MCP 服务器。完整的测试框架和数据集已在 GitHub 上的 ego-browser-benchmark-framework 仓库中公开。