
先说结论:不存在通吃的赢家,只有针对具体任务的赢家。按 AI Agent 的浏览器真正需要的四件事来打分(驱动界面的 Token 成本、登录态访问、并行能力、安装配置的麻烦程度),ego (lite) 排第一。把评分标准换成跨浏览器回归测试,Playwright 登顶;换成自主的自然语言任务,则是 Browser Use。
大多数“最佳浏览器自动化”榜单把解决不同问题的工具当成同一类产品来排名。CI 测试运行器和自主网页 Agent 都算“自动化浏览器”,把它们放进同一张排行榜,并不能告诉你哪个适合你的任务。
先看评分标准,再看排名就顺了。ego (lite) 是我们做的产品,它在这套评分标准下排第一。
2026 年,什么才算 AI 浏览器?
AI 浏览器通常指在浏览体验中内置助手或 Agent 的浏览器。外部浏览器自动化工具则不同:它给 Claude Code、Codex 或其他 Agent 提供一个控制浏览器的接口,形式往往是 CLI、MCP 服务器、扩展程序或托管会话。两者都能点击和读取页面,但产品边界、账号模型以及选择它们的理由并不一样。
当前的 AI 浏览器实例让这种区分变得具体。Perplexity 官方的 Comet 页面描述的是一款带助手的浏览器,可以研究、创作、发邮件、购物和委派任务,并提供 Mac、Windows、iOS 和 Android 下载。Dia 的官方页面主打 Morning Brief、跨 Slack、Notion、Calendar 和标签页的信息综合、可分别登录的浏览器配置文件(Profile)以及隐私控制;目前仅支持 Apple 芯片上的 macOS 14+。Sigma 的官方页面把浏览器内 AI Agent 与本地 Eclipse 处理、私有配置文件和基于 Chromium 的浏览结合在一起。Polar Browser 也属于这一类集成式浏览器。这些是日常主力产品,不是中立的自动化库。
ChatGPT Atlas 是一个值得引用的搜索结果案例,但并不是当前可以放心推荐的选择:OpenAI 自己的介绍页面现在写明 Atlas 已弃用,并引导读者转向 ChatGPT Work。如果一篇对比文章仍把 Atlas 当作在售选项,那它已经过时了。
| 类别 | 示例 | 最适合 | 需要留意的取舍 |
|---|---|---|---|
| AI 原生浏览器 | Comet、Dia、Sigma、Polar Browser | 内置助手的日常浏览器 | 厂商生态、套餐、记忆与隐私控制 |
| 外部 Agent 浏览器 | ego (lite)、Browser Use、Stagehand | 由编码 Agent 驱动可重复的网页工作 | 会话归属、模型成本与隔离 |
| 自动化框架或 MCP | Playwright、Puppeteer、Selenium、DevTools MCP | 确定性测试、CI 或深度诊断 | 安装配置、登录态维护与上下文开销 |
| 无状态浏览器引擎 | Cloudflare Kitesurf | 临时截图、HTML 提取与 PDF | 无状态会话;默认不保留长期浏览器配置文件(Profile) |
先看品类表,再对比功能清单。如果你想要一个自带对话和记忆、供个人日常使用的浏览器,就评估 AI 原生浏览器。如果你想要一个不绑定任何特定助手或桌面应用的浏览器,就评估外部 Agent 浏览器,例如 ego (lite)。如果你需要可复现的 CI 或性能追踪,就从下面的框架和 MCP 两行开始看。
这些工具是如何评分的?
四条评分标准,选它们的理由是:这些标准决定的是 Agent 的工作负载,而不是人的使用体验。Token 成本:Agent 与浏览器之间的接口有多重,因为把整棵无障碍树塞进上下文的快照格式,规模一大就是真金白银。登录态访问:工具能否在你已经登录的会话里操作,这决定了所有需要登录才能完成的任务。
并行能力:任务能否隔离并同时运行,还是只能在一个窗口里排队串行。安装配置成本:从安装到跑通第一个任务之间,还隔着多少配置。
有一点本文刻意不做:声称十一款工具跑过同一套任务基准,因为这样的基准并不存在。但自 2026 年 8 月起确实有一个:Real-World Bench,一个开放测试框架,用同一套 31 项任务、同一批真实网站、同一个模型(gpt-5.6-sol,max effort)和同一个独立评审,对五款工具做了对比。它测了 ego (lite)、Browser Harness(Browser Use 的本地版本)、Vercel 的 agent-browser、playwright-cli 和 chrome-devtools-cli;其中四款对应本文榜单里的条目,两款通过 CLI 路径的对应工具间接对应。下文某个条目如果在其中有成绩,引用数字时会注明 31 项任务的样本。其余条目不会编造任何一对一对比。
如果某款工具公布了自己的测量结果,本文会把它标注为该工具自己的说法,并附上它对比的对象。其余部分一律按有文档记录的能力评分。这才是“实测”的诚实版本:评分标准写得明明白白,事实有出处,营销数字就标明是营销数字。
面向 AI Agent 的 11 款最佳浏览器自动化工具是哪些?
下面这十一款分成四个类别:为 LLM 驱动而生的 Agent 原生工具、为 Agent 改造过的经典自动化框架、厂商出品的浏览器扩展程序,以及一款一体化 AI 浏览器加一款无状态浏览器引擎。按本文声明的评分标准,ego (lite) 排在第一;其余条目按角色排序,并不构成一条通用的质量阶梯。
1. ego (lite):你和你的 AI Agent 共用的浏览器。
ego (lite) 可以一键导入你符合条件且已授权的 Chrome 浏览器配置文件(Profile),让 Agent 从一个你已经登录的浏览器开始工作,两步验证(2FA)提示会少很多,不过某些网站仍可能要求验证。任何编码 Agent 都可以通过 ego-browser 这个开源 shell 入口连接,无需 SDK,但仍受网站自身的身份验证与策略检查约束。
它在这套评分标准下排第一,是因为在四条标准上都表现良好:符合条件的导入会话状态、每个任务一个独立 Space、Token 开销低的 JavaScript 工作流,以及免费的 Mac 版下载。其他工具也能通过持久化浏览器配置文件(Profile)、扩展程序或托管会话满足其中部分标准,所以请结合你自己的账号与合规策略确认是否适用。
这个排名的实测版本:在 Real-World Bench(31 项任务、真实网站、同一模型、同一评审,运行于 2026-08-19)中,ego (lite) 完美完成 31 项任务中的 93.5%,平均每项任务成本 $1.64。用这个平均值除以完成率,$1.64 ÷ 93.5%,每个完成的任务成本为 $1.75,是五款被测工具中最低的。它每项任务消耗的模型轮次也最少(30.3 轮,其余工具为 42.8 到 51.2 轮),最后一点,它还是五款中最快的,平均每项任务 398 秒。测试框架、任务与原始评审结果:citrolabs/ego-browser-benchmark-framework。
这些轮次数字背后的 Token 机制另有单独测量:已公布的 heredoc 基准显示,相比一次执行一条命令的方式,执行轮次减少 44%,工具调用减少 35.5%,成本降低 21.6%,因为许多操作可以合并到一个脚本轮次里。
这种精简接口在真实页面上是什么样,来自一段针对 Hacker News 的 ego-browser 会话录制:命令与输出原样呈现,不附带无障碍树转储。
ego-browser nodejs <<'EOF'
const task = await egoBrowser.newTaskSpace('evidence-egobrowser-hn')
console.log({ taskSpaceId: task.id })

await task.page.goto('https://news.ycombinator.com/', { waitUntil: 'load', timeout: 20000 })
const title = await task.page.title()
const topStory = await task.page.locator('.athing .titleline > a').first().innerText()
const points = await task.page.locator('.subtext .score').first().innerText().catch(() => null)
console.log({ title, url: task.page.url(), topStory, points })
EOF

# real output
{
  "taskSpaceId": 13
}
{
  "title": "Hacker News",
  "url": "https://news.ycombinator.com/",
  "topStory": "Qwen 3.8 27B",
  "points": "412 points"
}
说句实话的边界:它是桌面浏览器,所以无法在无头 CI 中运行,而且你是在采用一款产品,而不是拼装自己已经熟悉的库。
试用它只需从官方仓库执行一条命令,或者对你已经在用的 Agent 说一句提示词;它会安装 ego-browser skill,并带你走完剩下的步骤:
npx skills add citrolabs/ego-litePaste into your agent
Set up ego lite for me: https://github.com/citrolabs/ego-lite Read `skills/ego-browser/references/install.md` and follow the steps to install ego lite.
2. Browser Use:自主执行自然语言任务。
Browser Use(开源,MIT 许可,约110K GitHub stars)让 LLM 根据一句自然语言目标驱动浏览器:“找到最便宜的航班并填好表单。”当任务确实是自主、多步骤的,而不是固定脚本时,它是最佳选择;其近期版本通过 CDP 连接,开销更低。
实际用起来是什么样:一个 browser-use 0.13.7 的 Agent,后端接 OpenAI 模型,在 2026 年 8 月针对一个真实页面执行一句自然语言目标,不使用写死的选择器。(这是与上面 ego-browser 会话不同的另一次会话;该帖的投票数在多次运行之间会变化。)
import asyncio
from browser_use import Agent, ChatOpenAI

async def main():
    llm = ChatOpenAI(model="gpt-4.1-mini")
    agent = Agent(
        task="Go to https://news.ycombinator.com/ and tell me the exact title text of the #1 story on the front page, plus its points count.",
        llm=llm,
    )
    history = await agent.run(max_steps=8)
    print("FINAL RESULT:", history.final_result())

asyncio.run(main())

# real output (trimmed)
INFO     [Agent] Starting a browser-use agent with version 0.13.7, with provider=openai and model=gpt-4.1-mini
INFO     [Agent]   ▶️   navigate: url: https://news.ycombinator.com/, new_tab: False
INFO     [tools] 🔗 Navigated to https://news.ycombinator.com/
INFO     [Agent]
INFO     [Agent] 📍 Step 1:
INFO     [Agent]   👍 Eval: Successfully located the #1 story title and its points count on the Hacker News front page.
INFO     [Agent]   🧠 Memory: Located the top story on Hacker News with title 'Qwen 3.8 27B' and points count '415 points'.
INFO     [Agent]   🎯 Next goal: Report the exact title text and points count of the #1 story to the user.
INFO     [Agent]   ▶️   done: text: The #1 story on Hacker News front page is titled "Qwen 3.8 27B" with 415 points., success: True, files_to_display: None
INFO     [Agent]
📄  Final Result:
The #1 story on Hacker News front page is titled "Qwen 3.8 27B" with 415 points.

INFO     [Agent] ✅ Task completed successfully
FINAL RESULT: The #1 story on Hacker News front page is titled "Qwen 3.8 27B" with 415 points.
它有一行 Real-World Bench 数据,需要说明一个关系:被测工具是 Browser Harness,也就是 Browser Use 的本地版本;云端产品没有参与评测。Browser Harness 在五款工具中排名第二,31 个任务中有 77.4% 完美完成,平均每个任务 $2.43,按 77.4% 的完成率折算,每个完成的任务为 $3.14。它也是五款中模型轮次最多的(每个任务 51.2 轮):代价是每一步都要跑自己的决策循环。
它不是什么:确定性。由 LLM 驱动的导航每次运行都会变化,这对开放式任务是优点,对任何必须每次结果完全一致的任务则是隐患。
3. Playwright:确定性的跨浏览器控制。
Playwright(Microsoft)是可靠性标准:一套 API 覆盖 Chromium、Firefox 和 WebKit,自动等待让脚本保持稳定。面向 Agent 还有Playwright MCP,它通过无障碍树快照把浏览器暴露给 LLM。
它是回归测试和必须可复现运行的工作流的强力选择。Agent 侧的代价可能是上下文 Token:在复杂页面上结构化快照会变得很大,这正是本列表中更轻量接口所要回应的问题。
这个代价有一个具体数字:我们通过 Chrome DevTools MCP 在 Hacker News 上测到的一次 take_snapshot 为 38,285 个字符,虽然那是另一个服务器,但用的是与 Playwright MCP 相同的无障碍树快照设计。对于一个大约有三十个链接的页面,一次快照大约就是 9-10K Token,而上面 ego (lite) 对同一页面返回的定向 JSON 大约只有 110 个字符。这个差距就是本节所描述的成本形态。
Real-World Bench 也测了 Playwright 这条路线,需要加一条注释:被测工具是 playwright-cli,也就是官方 CLI,不是 MCP 服务器。它在 31 个任务中有 71.0% 完美完成,评分标准平均分 88.9%,说明它失败的任务里有很多是部分完成,平均每个任务 $3.42;$3.42 ÷ 71.0% 完成率,每个完成的任务为 $4.82。扎实、确定性的工具,但在 LLM 驱动时会被上面的快照经济性拖累。
4. Stagehand:基于 Playwright 的 AI 原生脚本。
Stagehand(Browserbase,TypeScript,约 24K stars)把 Playwright 包装成三个 AI 原语:act、extract 和 observe,所以你写的是意图(“点击登录按钮”),让模型去解析选择器。它是脆弱脚本和完全自主之间的中间路线。
Browserbase 报告它运行速度约为普通 Playwright 的 2 倍,Token 效率高 80%(这是他们自己的测量,基于他们的任务)。它偏向使用 Browserbase 云端来托管运行,如果你想要托管基础设施,这很合适;如果不想要,这就是成本。
5. Chrome DevTools MCP:调试级访问。
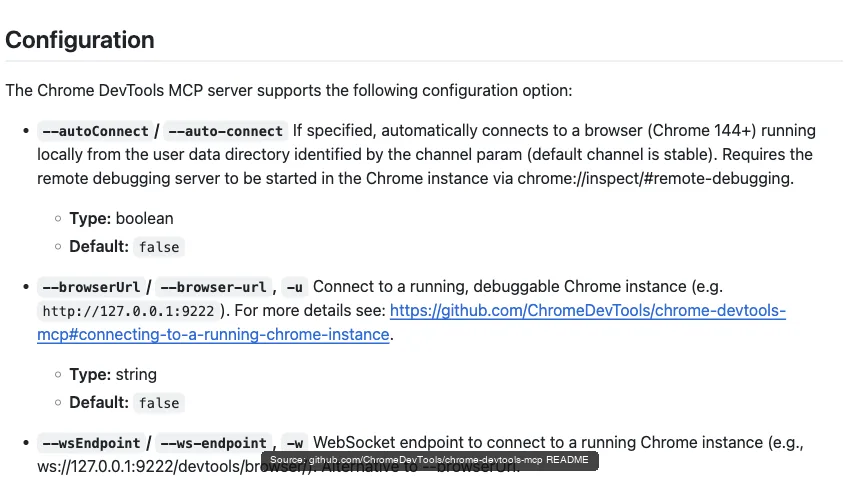
Chrome DevTools MCP(Google,官方)把 DevTools 界面、网络请求、控制台和性能追踪交给 Agent,它的--autoConnect 标志(Chrome 144+)会连接到你已经登录的浏览器。
当 Agent 需要检查和调试,而不只是点击时,它是首选:读取失败的请求、分析慢页面,或检查控制台错误。作为通用驱动,它比 Agent 原生工具更窄;当这些 DevTools 信号是决定性需求时,再选它。
这个界面有 Real-World Bench 数据,但和 Playwright 那一行有同样的说明:被测工具是 chrome-devtools-cli,也就是通往 DevTools 协议的 CLI 路线,不是 MCP 服务器本身。作为通用驱动,它在 31 个任务中有 61.3% 完美完成,是五款被测工具中最低的,平均每个任务 $4.95,按 61.3% 完成率折算,每个完成的任务为 $8.08。这应被看作对上一段的佐证:一个调试界面被硬拉去当通用驱动,而不是对它调试本行的贬低。
6. Claude for Chrome:面向 Claude 用户的标签页内代办。
Claude for Chrome是 Anthropic 的扩展程序,在你现有的标签页内操作,每个站点都会弹出权限提示。零配置和打磨过的消费级体验是它的吸引力所在。
厂商自己警告不要把它用于金融交易和凭证管理,因为提示注入防护并非万无一失。这是所有标签页内 Agent 的诚实边界:它掌握你的整个浏览器配置文件(Profile),所以你要让它远离你最敏感的界面。
7. Codex for Chrome:OpenAI 阵营的对应产品。
Codex for Chrome是 OpenAI 的对应产品,一个为 ChatGPT 和 Codex 用户在共享窗口工作流中驱动浏览器的扩展程序。它能访问的站点和操作取决于扩展程序当前的权限,其文档也带有同样的金融与凭证警告。
选择它的理由和选择 Claude for Chrome 一样,只是换了生态:当你的 Agent 生活在该厂商的世界里,且任务是有人监督的代办而非无人值守的运行,它是最省事的选择。
8. Selenium:兼容面最广。
Selenium是存活最久的,它的优势在于覆盖面:更多语言、更多浏览器,以及用于在现有测试环境中分布式运行的 Selenium Grid。mcp-selenium 服务器为 Agent 封装了 WebDriver。
当你受限于遗留基础设施或非主流语言栈时选它。对于全新的 Agent 项目,较新的工具更轻量,但当你需要时,Selenium 的兼容性无可匹敌。
9. Puppeteer:轻量级脚本化 Chrome。
Puppeteer(Google,Node)是脚本化 Chromium 工作的精简快速选项:PDF 生成、截图、简单的爬取。它只支持单一浏览器,且比 Playwright 更底层,这正是它轻量的原因。
对于执行确定性、仅限 Chrome 的任务,且你希望开销最小、控制完全的 Agent,它仍然是一个干净的答案,并且与直接编写脚本的编码 Agent 配合得很好。
10. Polar Browser:面向知识工作的集成式 AI 浏览器。
Polar Browser 是一款 AI 原生浏览器,面向研究、招聘、销售和运营等长时间运行的知识工作任务。它同时拥有浏览器体验和 Agent 运行时,所以它属于同一份列表,但服务于与 ego (lite)、Playwright 或 Browser Use 等外部控制面不同的赛道。
Polar 的官方介绍称其完成了由 Madrona 领投的 570 万美元种子轮融资,并在部分网页 Agent 基准测试中超过 OpenAI 和 Anthropic。这些是 Polar 自己的说法,并非独立验证;其官方文章也指出,基准测试的表现未必能预测真实的知识工作任务。目前 Real-World Bench 中没有针对 Polar 的同任务、独立评审记录,因此请对比工作负载、登录与隐私要求、并行能力、成本和可复现性。
11. Cloudflare Kitesurf:面向 Agent 工作负载的无状态浏览器引擎。
Cloudflare Kitesurf 是一款 Agent 优先的浏览器引擎,以无状态方式运行在 Cloudflare Workers 中,并对外暴露 Chrome DevTools Protocol。Puppeteer、Playwright、chrome-remote-interface 和 MCP 客户端都可以通过 Browser Run 驱动它。它面向对 Token 敏感、突发性的任务,而不是标签页、扩展程序、像素级精确渲染或人类长期使用的浏览器配置文件(Profile)。
Kitesurf 适合一次性截图、HTML 提取、PDF 生成和临时性的 Agent 任务;不适合需要持久登录态的浏览。Cloudflare 的文档指出,它目前还无法应对基于真实 TLS 指纹的机器人检测挑战,也无法启动需要持久状态的长时运行会话,其 beta/免费可用性还受账户额度限制。Cloudflare 公布了基于 14 个 URL 的 Quick Actions 语料库的中位数数据:相比预热好的 Chromium 池,截图消耗的 CPU 少 3.1 倍、内存少 4.7 倍,HTML 提取消耗的内存少 7.0 倍,但截图的总耗时多 1.8 倍。这些是 Cloudflare 自己的测量结果,并非跨工具基准测试。
下载 Mac 版 ego (lite),免费,或查看它与以下工具的正面实测对比: Browser Use、Stagehand 与 ego (lite) 对比。
它们横向对比的排名如何?
这张表把四项评分标准压缩到一个视图里。请把“最适合”一列当作决定性依据:排名针对的是本文评分的“Agent 驱动真实浏览器”这一场景,但你的任务可能更看重其他标准,这时应以“最适合”一列为准。
| 工具 | 类型 | 最适合 | 主要取舍 |
|---|---|---|---|
| ego (lite) | Agent 原生,真实浏览器 | 在你已登录的账号上并行处理日常任务 | 桌面端,不适合无头 CI |
| Browser Use | Agent 原生,开源 | 自然语言驱动的自主多步任务 | 每次运行结果不确定 |
| Playwright | 框架 + MCP | 确定性的跨浏览器测试 | 面向 Agent 的快照消耗大量 Token |
| Stagehand | 基于 Playwright 的 AI 层 | 抗变化的 AI 原生脚本 | 依赖 Browserbase 云服务 |
| Chrome DevTools MCP | 官方 MCP | 调试:网络、控制台、追踪 | 作为通用驱动偏窄 |
| Claude for Chrome | 厂商扩展程序 | 受监督的标签页内任务(Claude) | 作用于整个浏览器配置文件(Profile);不要用于金融场景 |
| Codex for Chrome | 厂商扩展程序 | 受监督的标签页内任务(OpenAI) | 作用于整个浏览器配置文件(Profile);不要用于金融场景 |
| Selenium | 框架 + MCP | 支持老旧表格页面,语言支持广 | 比新工具更重 |
| Puppeteer | 框架 | 轻量级脚本化 Chrome 任务 | 仅支持 Chromium,偏底层 |
| Polar Browser | 集成式 AI 浏览器 | 长时间运行的知识工作任务 | 受厂商运行时和套餐限制 |
| Cloudflare Kitesurf | 无状态浏览器引擎 | 临时截图、数据提取和 PDF 生成 | 无状态;默认不保留持久化浏览器配置文件(Profile) |
你的任务该选哪一款?
先别管排行榜,把工具和任务对上。大家搜索这类工具时想做的事,大多落在三种任务里。
给每天跑自动化的编码 Agent 用。 如果你想让 Claude Code 或其他编码 Agent 针对导入的浏览器配置文件执行已获授权的自动化操作,ego (lite) 会比较合适:Agent 可以在一次页面内 JavaScript 执行中完成多个动作,减少每个任务完成过程中模型与工具之间的往返次数。
在 CI 里做确定性测试。 如果任务是在裸服务器上跑回归测试,且要求在各浏览器上结果完全一致,答案是 Playwright;想要更轻的 Chromium 专用方案就用 Puppeteer;遇到必须兼容老系统的情况则用 Selenium。这些工具对无头浏览器友好、结果确定,而这恰恰是 Agent 原生工具为了灵活性所放弃的东西。
做开放式自主任务。 如果目标真正开放、事先并不知道具体步骤,首选 Browser Use;想要更多控制权和结构化数据提取就用 Stagehand。要接受自主性带来的代价:每次运行结果会有差异,所以它们更适合探索和一次性任务,而不是任何要求可复现的场景。
如何让浏览器自动化 Agent 在生产环境中稳定可靠?
把生产环境的浏览器自动化做成一条有边界的流水线:输入确定、显式等待页面状态、记录幂等、做校验、设检查点、让失败状态可观测。Agent 能适应布局变化,但没法让半加载的页面、变化的数据、验证码(CAPTCHA)或过期的会话变得可信。瞬时失败走有上限的重试,权限或账号类失败则交给人工或经批准的替代方案。
- 把输入稳定下来。 固定 URL、查询条件、语言区域、视口、测试数据、浏览器版本和账号范围。记录指纹或时间戳,这样数据源发生变化时能一眼看出来。
- 等待具名状态。 等待稳定的定位器、网络条件或应用状态,不要假设“加载完成”就等于“可以使用”。把加载中、就绪、空结果、被拦截、失败分别归类。
- 让重试是安全的。 对超时和临时性 5xx 响应做退避重试。不要把 401、403、验证码(CAPTCHA)、账号警告或基于条款的拒绝当成临时故障去重试。
- 校验并设置检查点。 校验必填字段、URL、类型、重复项和预期取值范围。每处理一条记录或一批数据后就保存进度和证据,这样后续失败不会抹掉已经确认的结果。
当需求是确定性断言和 CI 时,选 Playwright 或 Selenium;当任务多变、且你能接受人工复核时,选 Agent 原生浏览器。无论哪种情况,都要衡量成功率、被接受的记录数、人工恢复时间和每个被接受结果的成本,而不只是浏览器最终有没有动起来。
如何优化浏览器 Agent 的成本与 Token 用量?
优化成本的做法是:让模型和浏览器接口匹配任务,再减少不必要的观察。用小型模型或确定性代码处理路由和显而易见的字段,把更强的模型留给有歧义的部分,过滤无障碍快照,批量执行重复动作,缓存未变化的页面,并设置 Token 和动作预算。要比较每个被接受任务的成本,因为一次需要返工的便宜运行并不便宜。
- 按任务形态选模型。 只有当像素或视觉布局重要时才用具备视觉能力的模型;语义字段用 DOM 或无障碍输出。当数据本地性和基础设施可预测性比延迟与维护成本更重要时,用本地模型。
- 精简上下文。 关闭未使用的工具,返回定位器或行切片而不是整页快照,把截图或 trace 留在磁盘上,等到需要诊断时再取用。
- 批量化并缓存。 把重复读取放进一个脚本里执行,对未变化的页面做哈希或指纹,避免为重复的 URL 或相同的模型决策重复付费。
- 跟踪完整账单。 记录模型输入/输出 Token、浏览器耗时、重试次数、托管浏览器费用和人工复核。订阅、本地 GPU 或免费下载同样有运行成本。
如何选择模型并控制并行浏览器 Agent?
选择浏览器 Agent 模型,要看它在你的任务形态上实测的完成率、工具调用可靠性、延迟、上下文窗口和总成本,而不是只看排行榜。只有当每个 Agent 都有隔离的浏览器配置文件(Profile)或 Space、独立的账号范围、有界队列和统一的停止机制时,才运行并行 Agent。更多 Agent 能提升吞吐,同时也会放大频率限制、会话冲突和复核负担。
- 构建一个小型评测集。 选用有代表性的任务,覆盖动态页面、登录交接、空状态和一次性动作。评分看最终状态和证据,而不只是模型的自述。
- 隔离会话。 给每个 Agent 一个具名的配置文件(Profile)或 Space。除非工作流明确要求有人监督的共享,否则绝不要让两个身份共用 Cookie 或同一个活动窗口。
- 保留队列和急停开关。 限制并发数和单个来源的请求数,持久化状态,并允许操作员在不询问模型的情况下停止所有 worker 并吊销凭证。
公开的基准测试可以提供有用的参考点,但无法预测你的生产页面。更换模型、浏览器、提示词、账号或并发数之后要重新跑评测,因为这些改动会改变失败的分布。
什么时候该用无代码工作流自动化?
当工作流主要是稳定的触发器、API 动作、审批和数据映射时,用 Zapier、Make、n8n 或可视化 RPA 工具。把需要自适应 DOM 交互、登录态或人工交接的那一小步交给浏览器 Agent。可靠的模式是用编排包裹一个有边界的浏览器任务,而不是让 Agent 无限制地访问每一个连接器。
- 带范围地触发。 传入 URL、记录 ID 或调度时间,再加上负责人和授权依据。把这份范围随运行一起保存。
- 按状态分流。 把就绪的页面送去提取,把空页面送去诊断,把登录、验证码(CAPTCHA)、403 或频率限制状态交给人工或经批准的替代方案。
- 在产生副作用之前先校验。 在更新 CRM、发送外联、发布内容、支付账单或提交表单之前,先要求通过 schema 校验和审批。
可视化工具并不会自动更稳定:一次改版可以让录制好的流程失效,就像选择器变化会让代码出错一样。给工作流加上版本管理,监控漂移,并为关键任务保留手动兜底方案。
浏览器 Agent 如何处理动态 DOM 与网页抓取?
处理动态 DOM 时,按可访问角色、标签或稳定的测试标识来定位元素,等待能证明数据已就绪的状态,并在每次状态变化后重新读取 DOM。避免使用过长的 CSS 链和坐标。做网页抓取时,先明确需要的是可见的那一部分还是完整的分页数据集,然后记录查询、游标、时间戳以及缺失或被拦截的状态,避免把虚拟列表当成完整结果上报。
- 优先使用语义化定位器。 先用角色和可访问名称,其次用稳定的 data 属性,只有在页面没有更好的约定时才使用范围收窄的 CSS 选择器。
- 等待应用状态。 load 事件可能早于 hydration、懒加载或 React 过渡。等待稳定的定位器或响应,并把空、加载中、被拦截分别归类。
- 给提取设定边界。 设置页面数、行数和分页上限。每一行都保留来源 URL、检查时间和限制说明,遇到访问控制就停下,而不是提高并发。
当页面结构变化时,模型可以调整自己的理解,但它无法恢复从未渲染出来的数据,也无法获得被拒绝的权限。稳定的核心部分用确定性框架,把 Agent 推理留给真正会变化的部分。
Agent 应如何应对反机器人检测与会话?
把验证码(CAPTCHA)、Cloudflare 挑战、403、频率限制、反复登录失败或账号警告视为停止信号。确认任务已获授权,记录可见状态,放慢或结束本次运行,并在可用时改用官方 API、导出、授权数据源或人工交接。真实浏览器或代理并不保证能访问,也不等于有权绕过站点的控制。
- 不要绕过。 不要用程序解题,不要轮换身份,不要重放 Cookie,不要伪造指纹,也不要在被拒绝后反复重试直到成功。
- 隔离会话范围。 给每个账号分配一个命名且隔离的浏览器配置文件(Profile)或 Space。把个人、财务和管理类会话排除在通用抓取任务之外。
- 把部分结果明确标出来。 给被拦截、未认证和不完整的行标注来源与时间戳。绝不要把有限的结果说成完整抓取,也不要说成不会被封的工作流。
关于 Cloudflare 从站点所有者角度对挑战页面的说明,参见其文档。站得住脚的自动化做法是取得许可或停止,而不是使用隐蔽手段。
应该检查哪些隐私与安全控制项?
在使用 Agent 之前,先确认浏览器状态、页面内容、截图、提示词、模型请求和日志存放在哪里。阅读厂商的保留与训练条款,隔离浏览器配置文件(Profile),不要把密钥放进提示词,只允许任务需要的域名和工具。VPN 保护的是网络链路,它无法阻止拥有权限的浏览器扩展程序或 Agent 读取页面,密码管理器也不能让每一次自动化操作都变得安全。
| 问题 | 需要确认什么 |
|---|---|
| 会话数据存放在哪里? | 本地浏览器配置文件(Profile)、托管浏览器、加密、保留期限、删除 |
| Agent 能访问什么? | 域名、浏览器配置文件(Profile)、文件系统、shell、网络和工具权限范围 |
| 哪些数据会离开设备? | 页面文本、截图、trace、提示词、模型调用和日志 |
| 操作员能叫停它吗? | 外部终止开关、Token 吊销、队列取消、审计记录 |
对 Dia、Comet 这类集成式浏览器,以及 ego (lite)、Playwright、Browser Use 这类外部工具,都可以用同一套标准来审查。隐私承诺因产品和套餐而异;请查阅最新文档核实,不要因为它是本地处理、带了 VPN 或集成了密码管理器就默认它安全。
常见问题
面向 AI Agent 的浏览器自动化工具,哪个最好用?
取决于任务。用编码 Agent 自动化你已登录的网站,ego (lite) 最合适:它继承你真实的登录态。确定性的跨浏览器测试选 Playwright;自主的自然语言任务选 Browser Use。没有唯一的赢家,只有针对具体工作负载的最佳选择。
哪种浏览器自动化工具消耗的 Token 最少?
Token 成本取决于交互接口,而不是浏览器本身。基于无障碍树快照的方案(比如 Playwright MCP)会随页面复杂度增长,而 CLI 或代码驱动的接口只传递 Agent 主动请求的内容。ego (lite) 的 heredoc 基准测试报告称,相比逐条命令执行,执行轮次减少约 44%,成本降低 21.6%;Stagehand 报告称 Token 效率比纯 Playwright 提升约 80%。两者都是厂商自报数据,阅读时应以此为前提。在独立评测方面,Real-World Bench 实测的模型成本指向同一方向:ego (lite) 平均每任务 $1.64,而其余四款被测工具为 $2.43 到 $4.95。
有没有在相同任务上对比这些工具的基准测试?
没有覆盖全部十一款的。Real-World Bench 覆盖了五款:同一套 31 项任务,针对真实网站,使用同一模型(gpt-5.6-sol,max effort),由同一位独立评审对原始会话日志和截图打分。完美完成率结果:ego (lite) 93.5%,Browser Harness(Browser Use 的本地版本)77.4%,agent-browser 62.9%,playwright-cli 71.0%,chrome-devtools-cli 61.3%,均为 31 项任务套件的成绩。Playwright 和 DevTools 两行测的是 CLI 路径,不是 MCP 服务器。测试框架和数据集公开在 citrolabs/ego-browser-benchmark-framework 仓库中。
Browser Use 比 Playwright 更好吗?
它们解决的是不同问题。Browser Use 用自然语言目标驱动浏览器,擅长自主的开放式任务。Playwright 运行确定性脚本,擅长必须精确复现的测试。“更好”取决于哪个匹配你的任务:要灵活性用 Browser Use,要可靠性用 Playwright。
Polar Browser 真的比 OpenAI 和 Anthropic 更强吗?
Polar 声称在部分 web-agent 基准测试上击败 OpenAI 和 Anthropic,但这是厂商说法,并非本次对比中独立复现的结果。它自己的介绍也提醒,基准分数未必能预测真实知识工作的表现。在说任何 AI 浏览器更好之前,先评估具体任务、模型、浏览器上下文、登录要求、隐私策略、并行能力、成本,以及另一个团队能否复现这次运行。
这些浏览器自动化工具免费吗?
有几款是免费的。Browser Use、Playwright、Puppeteer、Selenium 和 Chrome DevTools MCP 是开源的,ego (lite) 可免费下载。Stagehand 开源,但托管运行更依赖付费的 Browserbase 云服务;各家厂商扩展程序则随其底层 AI 订阅一起提供。能免费运行和能免费规模化是两回事,值得逐款核实。
Cloudflare Kitesurf 用来做什么?
Kitesurf 面向无状态、突发式的 Agent 工作负载,比如截图、HTML 或 Markdown 提取、PDF,以及 CDP 驱动的自动化,这些场景下更看重低 CPU 和低内存,而不是像素级渲染或持久登录态。它不是本地 Chrome 配置文件,不是日常用的 AI 浏览器,也不是长时间运行且需要登录的会话的可靠方案。
这些工具能用我现有的登录态吗?
只有部分可以。ego (lite) 的设计就是继承你现有的浏览器会话;各家厂商扩展程序在你已登录的标签页内操作;Chrome DevTools MCP 可以通过 --autoConnect 连接到你的实时浏览器。经典框架(Playwright、Puppeteer、Selenium)从空白的浏览器配置文件启动,需要注入会话,对于有登录墙的任务来说,这增加了额外的工作和维护成本。
登录后才能抓取的场景,哪个工具最好?
能复用真实登录态的工具,因为注入的 Cookie 在两步验证(2FA)和设备检查面前会失效。ego (lite) 合适,因为 Agent 驱动的是已经登录的浏览器;各家厂商扩展程序适合在标签页内有人监督地抓取。完整的路线对比,以及无论用哪个工具都适用的合规边界,请参阅登录墙指南。